







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Observe o script SQL a seguir.
CREATE TABLE TB_PROC
(ID_PROC int , NM_JUIZ VARCHAR2(50),
PR_FASE VARCHAR2(50));
INSERT INTO TB_PROC (ID_PROC, NM_JUIZ, PR_FASE)
VALUES (1, 'A', 'CONTESTACAO');
INSERT INTO TB_PROC (ID_PROC, NM_JUIZ, PR_FASE)
VALUES (2, 'A', 'INSTRUCAO');
INSERT INTO TB_PROC (ID_PROC, NM_JUIZ, PR_FASE)
VALUES (3, 'B', 'INSTRUCAO');
INSERT INTO TB_PROC (ID_PROC, NM_JUIZ, PR_FASE)
VALUES (4, 'A', 'RECURSAL');
INSERT INTO TB_PROC (ID_PROC, NM_JUIZ, PR_FASE)
VALUES (5, 'B', 'CONTESTACAO');
SELECT COUNT(*)
FROM TB_PROC
WHERE NM_JUIZ = 'B' AND PR_FASE <> 'RECURSAL';
O resultado da execução do script SQL apresentado é:
1
2
3
4
5
A geração e o acúmulo contínuo de dados dos últimos anos impulsionaram o desenvolvimento de diversas tecnologias Big Data.
Uma das principais características de um banco de dados Big Data é:
garantir as propriedades ACID;
usar linguagem de consulta estruturada;
estruturar os dados em tabelas relacionais;
indexar os dados usando chaves naturais;
permitir esquema de dados dinâmicos ou schemaless.
Sobre subconsultas não relacionadas em SQL, é correto afirmar que:
A consulta principal (externa) é executada antes da subconsulta (interna).
A subconsulta pode ser incluída nas Instruções WHERE, HAVING e FROM.
Subconsulta de várias linhas retornam mais de uma coluna da instrução SELECT interna.
A condição de uma subconsulta envolve uma operação de igualdade entre uma coluna e o resultado que será retornado pela subconsulta.
Subconsulta de várias colunas retornam mais de uma linha da instrução SELECT interna.
Considere o esquema relacional que representa parte de um sistema de uma empresa:
Projetos(IdProjeto, nome)
Pessoas(IdPessoa, nome)
ProjetosPessoas(#IdProjeto,#IdPessoa)
Legenda: Campos sublinhados compõem a chave primária da tabela e campo precedido de # é uma chave estrangeira
A coordenação de recursos humanos deseja saber os nomes das pessoas que já trabalharam em todos os projetos cadastrados na base de dados. A consulta que expressa correta e eficientemente o que o relatório deve mostrar é:
SELECT * FROM Projetos, ProjetosPessoas, Pessoas WHERE USING(IdProjeto, IdPessoa) AND IdProjeto = ALL (SELECT * FROM Projetos) |
SELECT nome FROM Pessoas WHERE IdPessoa IN (SELECT IdPessoa FROM ProjetosPessoas WHERE EXISTS (SELECT * FROM Projetos)) |
SELECT nome FROM Pessoas PE WHERE NOT EXISTS (SELECT * FROM Projetos PR WHERE NOT EXISTS (SELECT * FROM ProjetosPessoas PP WHERE PE.IdPessoa = PP.IdPessoa AND PR.IdProjeto = PP.IdProjeto)) |
SELECT nome FROM PESSOAS PE WHERE EXISTS (SELECT IdPessoa FROM ProjetosPessoas LEFT JOIN Projetos) |
SELECT nome FROM Projetos PR WHERE EXISTS (SELECT * FROM Pessoas PE WHERE EXISTS (SELECT * FROM ProjetosPessoas PP WHERE PE.IdPessoa = PP.IdPessoa AND PR.IdProjeto = PP.IdProjeto)) |
Considere o esquema de um banco de dados ilustrado pela figura apresentada.
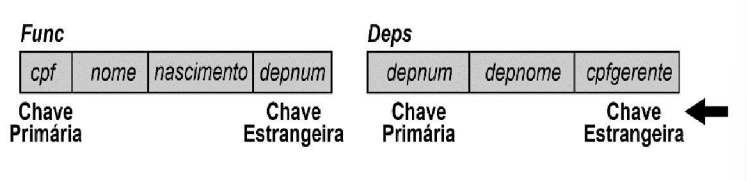
Para criar as tabelas desse esquema, um desenvolvedor usou os comandos da linguagem SQL apresentados.
CREATE TABLE Func ( cpf int NULL,
nome varchar (255) NOT NULL,
nascimento DATE,
depnum int NOT NULL,
PRIMARY KEY (cpf)
);
CREATE TABLE Deps (depnum int,
depnome varchar (255) NOT NULL,
cpfgerente int NOT NULL,
PRIMARY KEY (depnum)
);
Qual alternativa contém o comando correto para criar a chave estrangeira apontada pela seta no esquema?
ALTER TABLE Deps ADD CONSTRAINT DEP_GER FOREIGN KEY (cpfgerente) REFERENCES Func (cpf).
ALTER TABLE Func ADD CONSTRAINT FUNC_DEP FOREIGN KEY (depnum) REFERENCES Deps (depnum).
ALTER TABLE Deps ADD CONSTRAINT DEP_DEP FOREIGN KEY (depnome) REFERENCES Deps (depnum).
ALTER TABLE Func ADD CONSTRAINT FUN_DEP FOREIGN KEY (depnome) REFERENCES Func (depnum).
ALTER TABLE Deps ADD CONSTRAINT DEP_GER FOREIGN KEY (cpf) REFERENCES Func (cpfgerente).
No PostgreSQL 9.2, para criar um usuário deve‑se utilizar o comando GRANT.
Certo
Errado
Em um banco de dados multidimensional, frequentemente modelado como um cubo de dados, as dimensões são diferentes perspectivas sob as quais os dados podem ser analisados, e os fatos são os dados mais importantes que são analisados ou consultados em relação a essas dimensões.
Considere um esquema multidimensional que envolve automóveis, os fabricantes e as revendedoras de carros, com as tabelas Dimensão apresentadas a seguir:
1. Dim_Automóvel:
o Modelo_ID (identificador único para cada modelo de carro)
o Nome_Modelo (por exemplo: Corolla, Civic, Tucson)
o Tipo (por exemplo: Sedan, SUV, Coupe)
o Ano_Lançamento
2. Dim_Fabricante:
o Fabricante_ID (identificador único para cada fabricante)
o Nome_Fabricante (por exemplo: Toyota, Honda, Ford)
o País_Origem (por exemplo: Japão, EUA, Alemanha)
3. Dim_Revendedora:
o Revendedora_ID (identificador único para cada revendedora)
o Nome_Revendedora
o Localização (cidade e estado)
o Tipo_Revenda (por exemplo: autorizada, independente)
A tabela Vendas, que representa fatos, contém as seguintes colunas:
• Modelo_ID (chave estrangeira para Dim_Automóvel)
• Fabricante_ID (chave estrangeira para Dim_Fabricante)
• Revendedora_ID (chave estrangeira para Dim_Revendedora)
• Quantidade_Vendida
• Receita_Total (o total em vendas para essa tripla: modelo, fabricante e revendedora)
• Data_Venda
Qual das seguintes expressões, na linguagem de consultas SQL, retorna a receita total de vendas de carros do tipo SUV em 2023, agrupada por fabricante, na cidade de São Paulo?
SELECT f.Nome_Fabricante, SUM(v.Receita_Total) AS Receita_Total
FROM Tbl_Vendas v
JOIN Dim_Automóvel a ON v.Modelo_ID = a.Modelo_ID
WHERE a.Tipo = 'SUV'
AND r.Localização = 'São Paulo'
AND a.Ano_Lançamento = 2023
GROUP BY f.Nome_Fabricante;
SELECT f.Nome_Fabricante, SUM(v.Receita_Total) AS Receita_Total
FROM Tbl_Vendas v
LEFT JOIN Dim_Automóvel a ON v.Modelo_ID = a.Modelo_ID
JOIN Dim_Fabricante f ON v.Fabricante_ID = f.Fabricante_ID
WHERE a.Tipo = 'SUV'
AND a.Ano_Lançamento = 2023
GROUP BY f.Nome_Fabricante;
SELECT f.Nome_Fabricante, SUM(v.Receita_Total) AS Receita_Total
FROM Tbl_Vendas v
JOIN Dim_Automóvel a ON v.Modelo_ID = a.Modelo_ID
JOIN Dim_Fabricante f ON v.Fabricante_ID = f.Fabricante_ID
JOIN Dim_Revendedora r ON v.Revendedora_ID = r.Revendedora_ID
WHERE a.Tipo = 'SUV'
AND a.Ano_Lançamento = 2023
AND r.Localização = 'São Paulo'
GROUP BY f.Nome_Fabricante;
SELECT r.Localização, SUM(v.Receita_Total) AS Receita_Total
FROM Tbl_Vendas v
JOIN Dim_Automóvel a ON v.Modelo_ID = a.Modelo_ID
JOIN Dim_Fabricante f ON v.Fabricante_ID = f.Fabricante_ID
WHERE a.Tipo = 'SUV'
AND a.Ano_Lançamento = 2023
GROUP BY r.Localização;
SELECT f.Nome_Fabricante, COUNT(v.Receita_Total) AS Receita_Total
FROM Tbl_Vendas v
JOIN Dim_Automóvel a ON v.Modelo_ID = a.Modelo_ID
JOIN Dim_Fabricante f ON v.Fabricante_ID = f.Fabricante_ID
JOIN Dim_Revendedora r ON v.Revendedora_ID = r.Revendedora_ID
WHERE a.Tipo = 'SUV'
AND a.Ano_Lançamento = 2023
AND r.Localização = 'São Paulo'
GROUP BY f.Nome_Fabricante;
Em um banco de dados, o recurso de controle de dados inseridos em cada coluna, cujo objetivo é avaliar, por meio de expressões como “menor que” e “maior que”, entre outras, intervalos válidos para os valores denomina-se
nulidade.
unicidade.
valor padrão.
restrições de verificação.
duplicidade.
Dadas as tabelas Escritor (cpf, nome), Livro(isbn, titulo, data_publicacao) e Publica(cpf, isbn), como ficam as cláusulas From e Where de uma consulta SQL para exibir os nomes dos escritores dos livros ainda sem data de publicação? Considere que os atributos sublinhados são chaves primárias.
From Publica P join Livro L on (P.isbn = L.isbn) Where L.data_publicacao is null
From Publica P join Livro L on (P.isbn = L.isbn) Where L.data_publicacao in null
From Escritor E join Livro L on (E.cpf = P.cpf AND P.isbn = L.isbn) Where L.data_publicacao is null
From Escritor E join Publica P on (E.cpf = P.cpf) join Livro L on (P.isbn = L.isbn) Where L.data_publicacao is null
From Escritor E join Publica P on (E.cpf = P.cpf) join Livro L on (P.isbn = L.isbn) Where L.data_publicacao in null
Views, em bancos de dados relacionais, configuram um importante mecanismo para flexibilizar o acesso aos dados armazenados. Em alguns casos, são ditas atualizáveis, pois podem ser utilizadas como alvo de comandos SQL como insert, update, delete.
Uma característica que não impede uma view de ser atualizável é:
a clásula group by;
a cláusula distinct;
a cláusula order by;
a presença do operador algébrico union;
a inexistência de uma fonte de registros atualizáveis na cláusula from.
Um banco de dados em grafo é uma coleção de vértices, que representa uma entidade; e de relações, que representam a conexão entre vértices. A cláusula do Microsoft SQL Server que dá suporte à correspondência de padrões e à navegação de vários saltos por meio de grafo é:
PATH
STREAM
CONTAINS
PREDICT
MATCH
Assinale o número de linhas, além dos títulos, produzidas pela execução do comando SQL apresentado anteriormente.
3 linhas.
4 linhas.
5 linhas.
6 linhas.
Segundo a linguagem PL/SQL utilizada pelo sistema gerenciador de bancos de dados Oracle (21c), a forma de se declararem comentários de uma linha, em meio a um código, é:
- - Comentário utilizado no PL/SQL
/ / Comentário utilizado no PL/SQL
% % Comentário utilizado no PL/SQL
# # Comentário utilizado no PL/SQL
$ $ Comentário utilizado no PL/SQL
Na linguagem SQL, qual operador pode ser utilizado para verificar se o valor de um campo é diferente de nulo?
<>
IS NOT NULL
NOT EXISTS
<NULLABLE>
!=
Em um banco de dados aberto e em condições ideais, onde existem as tabelas tribunal e cidadão com a coluna chamada cpf _ cidadao para estabelecer a ligação entre elas, considere a seguinte expressão SQL:
SELECT tribunal, regiao_forum, cpf_cidadao, endereco_cidadao
FROM tribunal
INNER JOIN cidadao
....I ;
Para a expressão ser correta, a lacuna I deve ser preenchida por
ON tribunal.cpf_cidadao = cidadao.cpf_cidadao;
LIKE tribunal.cpf_cidadao = cidadao.endereco_cidadao ;
ON EXISTS tribunal.cpf_cidadao = cidadao.endereco_cidadao;
WHERE tribunal.cpf_cidadao = cidadao.cpf_cidadao;
ON tribunal.endereco_cidadao = cidadao.cpf_cidadao;
A instrução SQL não será executada, pois há um erro de sintaxe na linha 4, já que a função NVL não pode ser utilizada com a função TRUNC.
Certo
Errado
Em uma instrução SQL, a finalidade do operador DISTINCT em uma consulta SELECT, permite:
Ordenar os resultados em ordem alfabética
Filtrar os registros duplicados
Agregar valores em uma coluna específica
Realizar uma junção entre duas tabelas
Limitar o número de linhas retornadas pela consulta
Alison utilizou o seguinte comando SQL para inserir registros em uma tabela.
INSERT INTO TB_A (COL_1, COL_2)
SELECT COL_X, COL_Y
FROM TAB_B;
Após a execução do comando, Alison percebeu que a tabela origem dos dados estava errada, deveria ser TB_C. Para apagar os registros da tabela TB_A mantendo sua estrutura, Alison deve executar o comando:
DROP TABLE TB_A;
ALTER TABLE TB_A ADD COL_Y INT, COL_Y INT;
DELETE FROM TABLE TB_A WHERE COL_X = COL_Y;
UPDATE TB_A SET 1=1;
TRUNCATE TABLE TB_A.
O administrador de banco de dados do TJSE deverá criar um script em MySQL para realizar a carga de dados da TABELA A para a TABELA B, considerando que:
∙ a TABELA A foi criada pelo script:
CREATE TABLE a (
id INT AUTO_INCREMENT PRIMARY KEY,
descricao VARCHAR(255) NOT NULL,
custo DECIMAL(10, 2),
tipo CHAR(1),
CHECK (tipo IN ('A', 'B', 'C'))
);
∙ a TABELA B foi criada pelo script:
CREATE TABLE b (
id INT AUTO_INCREMENT PRIMARY KEY,
descricao VARCHAR(255) NOT NULL,
custo DECIMAL(10, 2) NOT NULL,
tipo TINYINT,
CHECK (tipo IN (1,2,3))
);
∙ A TABELA A foi carregada e a coluna CUSTO possui valores NULOS.
O script para carregar os dados da TABELA A para a TABELA B é:
INSERT INTO b
SELECT *
FROM a;
COMMIT;
INSERT INTO b (id, descricao, custo, tipo)
SELECT id, descricao, custo, tipo
FROM a
WHERE custo is NOT NULL;
COMMIT;
INSERT INTO b (id, descricao, custo, tipo)
SELECT id, descricao, custo, tipo
FROM a
WHERE custo is NOT NULL
AND tipo IN (1, 2, 3);
COMMIT;
INSERT INTO b (id, descricao, custo, tipo)
SELECT id, descricao, COALESCE(custo, 0) as
custo,
CASE tipo
WHEN 'A' THEN 1
WHEN 'B' THEN 2
WHEN 'C' THEN 3
END AS tipo
FROM a;
COMMIT;
INSERT INTO b (id, descricao, custo, tipo)
SELECT id, descricao, COALESCE(custo, 0) as
custo,
CASE tipo
WHEN 1 THEN 'A'
WHEN 2 THEN 'B'
WHEN 3 THEN 'C'
END AS tipo
FROM a;
COMMIT;
Analise o comando a seguir quando aplicado à tabela T1, anteriormente descrita.
delete from T1
where A >= (select min(A) from T1)
and A <= (select max(A) from T1)
O efeito desse comando sobre a tabela T1 é:
nulo, pois nenhuma linha é removida;
a remoção da primeira e da segunda linhas, somente;
a remoção da primeira e da terceira linhas, somente;
a remoção da segunda e da terceira linhas, somente;
a remoção de todas as linhas.



