







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Como relacionamentos do tipo 1 para n (1:N) podem ser implementados em bancos de dados relacionais?
1. Utilizando Triggers
2. Utilizando chaves estrangeiras
3. Utilizando relações de relacionamentos
Assinale a alternativa que indica todas as afirmativas corretas.
É correta apenas a afirmativa 2.
São corretas apenas as afirmativas 1 e 2.
São corretas apenas as afirmativas 1 e 3.
São corretas apenas as afirmativas 2 e 3.
São corretas as afirmativas 1, 2 e 3.
Considere as seguintes definições do contexto dos bancos de dados relacionais, com lacunas a preencher, e assinale a alternativa que preencha corretamente as três definições, considerando sua ordem.
1. Chave __________: Faz referência a uma chave primária em outra tabela, criando uma ligação entre as tabelas.
2. Chave __________: É uma chave que é composta por mais de uma coluna e que juntas formam uma chave única.
3. Chave __________: Pode ser utilizada como uma chave primária, mas pode não ser selecionada para tal fim devido a outros motivos, como tamanho ou performance.
candidata – estrangeira – composta
pública – primária – privada
estrangeira – pública – privada
candidata – estrangeira – estrangeira
estrangeira – composta – candidata
Assinale a alternativa correta sobre as chaves primárias em bancos de dados relacionais.
A chave primária é uma combinação única de valores que identifica univocamente cada linha de uma tabela.
A chave primária é um atributo que pode ter valores duplicados dentro de uma tabela.
Uma tabela pode ter várias chaves primárias.
A chave primária pode ser um atributo que não é obrigatório.
A chave primária pode ser compartilhada entre várias tabelas.
A necessidade de que haja o controle de concorrência em bancos de dados relacionais tem como objetivo básico
proibir o armazenamento de valores nulos nas tabelas do banco de dados.
não permitir a existência de atributos do tipo booleano nas tabelas do banco de dados.
limitar o número de atributos em cada tabela do banco de dados.
limitar o tamanho máximo de armazenamento do banco de dados.
permitir que haja mais de um usuário acessando, simultaneamente, um objeto do banco de dados.
Considere a seguinte cláusula escrita na sintaxe ANSI SQL
SELECT * FROM Customers
WHERE name LIKE "%Silva";
Relacionado à tabela clientes (Customers), o objetivo desta cláusula é exibir
todos os registros.
os registros cujo campo nome (name) finalize com Silva.
os registros cujo campo nome (name) inicie com Silva.
os registros cujo campo nome (name) contenha em qualquer lugar Silva.
os registros cujo campo nome (name) seja exatamente Silva.
Quanto aos principais benefícios da normalização em banco de dados. Analise as alternativas e assinale a que esteja tecnicamente incorreta.
Ajuda a reduzir o custo de armazenamento e aumenta a consistência dos dados armazenados
A normalização permite ajudar a garantir a melhora na integridade dos dados
Aumento do tamanho do banco de dados tornando-o mais complexo e enigmático
A performance da base de dados pode ser melhorada com a técnica de normalização
Qual das propriedades abaixo NÃO constitui uma característica que distingue a abordagem de banco de dados relacional de uma abordagem tradicional de processamento de arquivos?
Natureza de autodescrição da base de dados.
Isolamento entre programas e arquivos de dados.
Suporte a múltiplas visões de dados.
Suporte a recursos de data analytics, tais como algoritmos de aprendizado de máquina.
Suporte a transações concorrentes em ambientes multiusuário.
Qual a vantagem da dicionarização de um banco de dados relacional?
Aumenta a flexibilidade da base de dados.
Facilita a implementação de restrições de integridade.
Melhora o desempenho da base de dados.
Não permite incluir informações redundantes na base de dados.
Reduz processo de atualização da base de dados.
No modelo relacional, um banco de dados é visto como um conjunto de relações. Um dos conceitos importantes é a restrição de integridade referencial entre tuplas do banco de dados. Considere uma chave estrangeira que não pode ter valor nulo em uma relação. Em qualquer tupla dessa relação, o valor dessa chave estrangeira deve ser
igual a um dos valores do índice secundário referenciado.
igual a um dos valores da chave primária referenciada.
distinto de qualquer um dos valores do índice secundário referenciado.
distinto de qualquer um dos valores da chave primária referenciada.
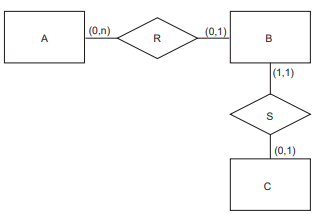
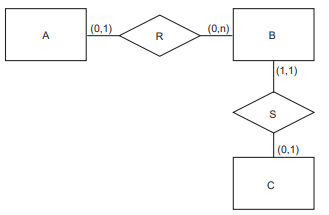
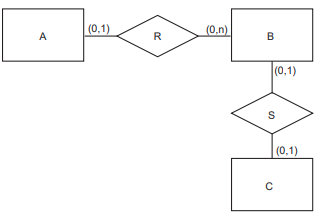
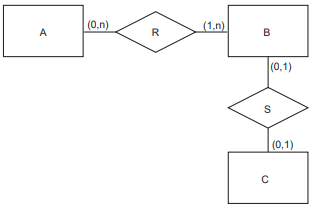
Os conjuntos a seguir representam o estado de um banco de dados relacional.
A = { a1, a2, a3 }
B = { b1, b2 }
C = { c1, c2, c3 }
R = { (a1, b1), (a1, b2), (a2, b1), (a2, b2), (a3, b1) }
S = { (b1, c2), (b2, c3) }
Admita que os elementos dos conjuntos acima sejam instâncias das entidades ou das relações de mesmo nome presentes no diagrama E-R a partir do qual o esquema do banco de dados acima foi obtido, e que as regras definidas nesse diagrama E-R são preservadas pelo banco de dados em questão.
Nesse contexto, qual diagrama E-R tem suas regras preservadas pelo banco de dados acima?
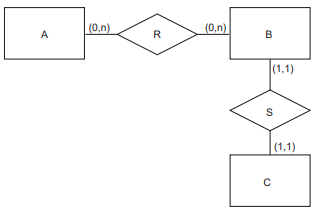
Em um banco de dados relacional, uma tabela é um conjunto não ordenado de linhas. Cada uma dessas linhas também é conhecida como:
Atributo.
Objeto.
Campo.
Lista.
Tupla.
Qual é a diferença entre normalização e desnormalização de dados?
Normalização é o processo de otimização da estrutura dos dados para evitar redundâncias e inconsistências, enquanto a desnormalização é o processo de adicionar redundâncias propositalmente para melhorar o desempenho de consultas frequentes.
Normalização é o processo de aumentar a redundância de dados para aumentar a segurança, enquanto a desnormalização é o processo de remover a redundância para economizar espaço de armazenamento.
Normalização é o processo de agrupar dados relacionados em uma única tabela, enquanto a desnormalização é o processo de dividir dados relacionados em várias tabelas para melhorar a escalabilidade.
Normalização é o processo de modificar a estrutura de dados para atender a requisitos específicos de aplicativos, enquanto a desnormalização é o processo de restaurar dados em uma estrutura original após um processo de normalização.
Normalização e desnormalização são sinônimos que descrevem o processo de modificação de dados para atender a diferentes requisitos de aplicativos.
Assinale a alternativa que apresenta a representação correta do relacionamento, em um banco de dados relacional, para a seguinte regra: um fisioterapeuta pode atender a vários pacientes e um paciente pode ser atendido por vários fisioterapeutas.
1:n
n:n
n:1
1:1
0:1
Em relação às formas normais, marque V para verdadeiro ou F para falso. Em seguida, assinale a alternativa com a sequência correta.
( ) Atributos compostos, multivalorados ou grupo repetidos de dados são permitidos na tabela que está na 1FN.
( ) A 2FN só é aplicável para tabelas que possuam uma chave primária composta e que, além disso, tenham outros atributos que não façam parte da chave primária.
( ) A tabela que está na 3FN possui dependências transitivas.
( ) Toda tabela está na 1FN se os seus atributos forem atômicos.
( ) A dependência transitiva é eliminada criando-se uma nova tabela que conterá o atributo que depende mais o atributo do qual ele é dependente.
F - F - V - F - V
V - V - F - V - F
F - V - F - V - V
V - F - V - F - V
Considere uma tabela denominada Tablet, de um banco de dados relacional. É necessário acrescentar um novo atributo (Fonte) a essa tabela, do tipo inteiro (supor que haja o tipo Integer no gerenciador a ser utilizado).
O comando SQL para realizar tal tarefa é:
ALTER TABLE Tablet
PLUS Fonte (Integer);
ALTER TABLE Tablet
ADD Fonte (Integer);
ALTER TABLE
ADD Tablet.Fonte (Integer);
ALTER TABLE Tablet >> Fonte (Integer);
ALTER TABLE Tablet ++ Fonte (Integer);
Ao desenvolvermos sistemas, a persistência de dados é realizada em um banco de dados, que normalmente opera sob a linguagem SQL, desta foram, o que é o conceito de chave primeira em banco de dados.
Uma coluna que armazena valores inteiros e que podem se repetir
Uma coluna que armazena valores exclusivos para cada registro na tabela
Uma coluna que armazena valores em forma de texto, para serem recuperados
Uma coluna que armazena valores com diversos tipos de dados
O que é modelo relacional?
O modelo relacional é a maneira mais simples de armazenar dados, pois todos os dados são armazenados em grafos.
O modelo relacional é um modelo de dados que é usado para representar relações entre dados em forma de tabelas.
O modelo relacional é um modelo de dados que utiliza o conceito de índice para representar as relações entre os dados.
O modelo relacional é uma abordagem de dados que é baseada em um conjunto de regras que descrevem como os dados devem ser manipulados.
O modelo relacional é um modelo de dados que utiliza a lógica hierárquica para representar as relações entre os dados de forma tabular.
Uma relação que esteja na quinta forma normal (5FN) está necessariamente livre de anomalias que sejam passíveis de serem eliminadas a partir de projeções.
Certo
Errado
O conceito fundamental para estabelecer relações entre linhas de tabelas em um banco de dados relacional é a chave. Em um banco de dados relacional, existem pelo menos três tipos de chaves que devem ser consideradas: chave primária, chave alternativa e chave estrangeira. Em relação à chave estrangeira em uma tabela relacional, assinale a alternativa correta.
É uma coluna ou um conjunto de colunas que referenciam a chave alternativa de outra tabela.
É uma coluna ou um conjunto de colunas que referenciam a chave primária de outra tabela.
É uma coluna ou um conjunto de colunas que referenciam a chave primária da mesma linha.
É uma coluna ou um conjunto de colunas que referenciam a chave alternativa da mesma tabela.
É uma coluna ou um conjunto de linhas que referenciam qualquer chave de outra tabela.
Nos bancos de dados relacionais, é necessário ter mecanismos de controle de concorrência, sendo um desses mecanismos representado pelo uso de protocolos baseados em bloqueios. Considerando os modos compartilhado e exclusivo utilizados nesse tipo de protocolo, é correto afirmar que
no modo exclusivo, uma transação pode ler, mas não escrever sobre um item de dados.
no modo compartilhado, uma transação pode ler e escrever sobre um item de dados.
tanto no modo exclusivo como no compartilhado, uma transação pode ler e escrever sobre um item de dados.
no modo exclusivo, uma transação pode ler e escrever sobre um item de dados.
tanto no modo exclusivo como no compartilhado, uma transação pode ler, mas não escrever sobre um item de dados.



