







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
No PostgreSQL (versão 9.2), os arquivos de texto criados pelo comando pg_dump devem ser lidos pelo programa psql. De forma geral, o comando para restaurar um dump com o programa psql é:
psql dbname < infile
Onde infile é um arquivo gerado através da saída do comando pg_dump e dbname é o nome de um banco de dados previamente criado. Por padrão, o programa psql continuará a executar o script contido no arquivo infile, mesmo depois que erros SQL forem encontrados. Se for desejado, é possível forçar a parada do comando psql caso encontre errros SQL, utilizando o seguinte comando:
No sistema gerenciador de bancos de dados PostgreSQL (v. 9.5), o comando para renomear uma coluna chamada Alfa para a denominação Beta, da tabela denominada Produto, é:
ALTER TABLE Produto
RENAME COLUMN Alfa TO Beta
MODIFY TABLE Produto
COLUMN NAME Alfa TO Beta
CHANGE TABLE Produto
COLUMN Alfa INTO Beta
TRANSFORM TABLE Produto
COLUMN NAME Alfa TO Beta
REVERSE TABLE Produto
SET COLUMN Alfa INTO Beta
Considere a execução da seguinte consulta no PostgreSQL 9.5:
WITH RECURSIVE t(n) AS (
VALUES (1)
UNION ALL
SELECT n+1 FROM t
)
SELECT * FROM t;
O resultado da execução é:
Mensagem de erro, sinalizando erro de sintaxe.
Mensagem de erro, sinalizando que a tabela t não existe.
Retorna uma tabela com um único registro, contendo o valor 1 (inteiro um).
Retorna uma tabela com dois registros, contendo os valores 1 e 2 (inteiros um e dois).
Consulta entra em um ciclo, sem condição definida de término.
Analise a definição das tabelas “candidato” e “pagamento”, bem como os registros que foram inseridos. Responda às questões 11, 12, 13 e 14, considerando o script 1.
create table candidato
(
inscricao integer,
nome character varying(50),
nome_social character varying(50),
primary key(inscricao)
);
insert into candidato
values
(1, 'PAULO SILVEIRA', 'CLAUDIA SILVEIRA'),
(2, 'ANDRE CARDOSO', NULL),
(3, 'JOANA GONZALES', 'MARCOS GONZALES'),
(4, 'ALESSANDRA BENERI', NULL),
(5, 'FERNANDO SIQUEIRA', NULL),
(6, 'CARLOS FERNANDEZ', NULL),
(7, 'DANIEL OLIVEIRA', NULL);
create table pagamento
(
id_arquivo integer,
nosso_numero character varying(17),
dt_liquidacao date,
vlr_recebido double precision,
primary key(id_arquivo, nosso_numero)
) ;
insert into pagamento
values
(1, '90293840000000001', '2018-02-11', 90),
(1, '90293849999999991', '2018-02-11', 90),
(1, '90293840000000002', '2018-02-11', 90),
(2, '90293840000000003', '2018-02-12', 90),
(2, '90293840000000004', '2018-02-12', 90),
(3, '90293849999999992', '2018-02-13', 90),
(3, '90293840000000005', '2018-02-13', 90);
Script 1
Considerando os registros existentes na tabela “candidato”, qual consulta SQL seria necessária executar no PostgreSQL, versão 9.2, para que se obtenha EXATAMENTE o mesmo resultado da figura 1?
nome character varying (50) | tem_nome_social boolean | |
1 | ALESSANDRA BENERI | f |
2 | ANDRE CARDOSO | f |
3 | CARLOS FERNANDEZ | f |
4 | DANIEL OLIVEIRA | f |
5 | FERNANDO SIQUEIRA | f |
6 | JOANA GONZALES | t |
7 | PAULO SILVEIRA | t |
Figura 1 - Resultado esperado.
select nome, nome_social::boolean as tem_nome_social from candidato order by 1
select nome, (nome_social is false) as tem_nome_social from candidato order by 1
select nome, (nome_social is true) as tem_nome_social from candidato order by 1
select nome, cast(nome_social as boolean) as tem_nome_social from candidato order by 1
select nome, (nome_social is not null) as tem_nome_social from candidato order by 1
Em um sistema gerenciador de banco de Postgres a coluna SALARIO da tabela COLABORADOR foi definida como NUMERIC(8,2) e a coluna JUROS foi definida como NUMERIC (2,2). Foi criada uma view com a seguinte expressão:
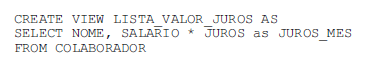
Assinale a opção que apresenta o tipo de dado da coluna JUROS_MES criado na view resultante dessa expressão.
Analise as instruções CREATE TABLE a seguir, escritas no SGBD PostgreSQL 9.0.23.
CREATE TABLE cidade
(nome____ text,
populacao__ float,
altitude____ int);
CREATE TABLE capital
(estado ____ char(2) )
INHERITS (cidade);
A relação entre as tabelas cidade e capital implementa o importante conceito de:
particionamento.
herança.
domínio.
extensão.
Em um Banco de Dados PostgreSQL, Joana precisa criar uma trigger para inserir dados na tabela de auditoria chamada AGENTE_AUDIT todas as vezes que um registro da tabela AGENTE for efetivamente excluído.
Para isso, considerando que a função "agente_removido()" já esteja implementada, Joana utilizará o comando:
O comando PostgreSQL abaixo, apresenta qual saída?
SELECT COALESCE (1, 2, 3, 4, 5);
1
5
1, 2, 3, 4, 5
5, 4, 3, 2, 1
NULL
O resultado de duas consultas pode ser combinado na linguagem PostgreSQL através da seguinte sintaxe:
comando1 UNION [ALL] comando2
comando1 INTERSECT [ALL] comando2
comando1 EXCEPT [ALL] comando2
Com base nessa sintaxe, é correto afirmar que
UNION anexa o resultado do comando2 no resultado do comando1, na ordem em que as linhas são retornadas pela consulta.
UNION ALL anexa o resultado do comando2 no resultado do comando1, eliminando as linhas duplicadas.
INTERSECT retorna todas as linhas presentes tanto no resultado do comando1 quanto no resultado do comando2, eliminando as linhas duplicadas.
INTERSECT ALL retorna todas as linhas presentes no resultado do comando1 que não estão presentes no resultado do comando2.
EXCEPT ALL retorna as linhas que estão no resultado do comando2, mas não estão no resultado do comando1, mantendo as linhas duplicadas.
Um database cluster do PostgreSQL é acessível por apenas uma instância de um servidor de banco de dados em execução.
Certo
Errado
Sobre os parâmetros de configuração para coleta de estatísticas no PostgreSQL, é correto afirmar que
track_activities armazena o log dos blocos de leitura e de escrita.
track_io_timing monitora as atividades de entrada e saída de dados.
track_service monitora o comando atual que está sendo executado por qualquer processo do servidor.
track_index verifica se as estatísticas são recolhidas sobre os acessos às tabelas e aos índices.
track_functions acompanha o uso das funções definidas pelos usuários.
Com relação ao sistema de replicação, disponível para o PostgreSQL, denominado Slony-I, analise as afirmativas a seguir:
I. Permite a replicação em cascata, master→slave→slave.
II. Permite que um componente slave seja empregado no papel de master em caso de falha deste.
III. É um componente nativo, que implica pequeno esforço de instalação e configuração.
É correto concluir que:



