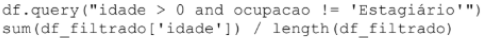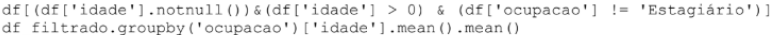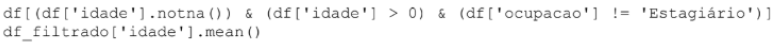Seu próximo nível começa aqui
Seu desenvolvimento não pode ter limites. Garanta sua Assinatura Ilimitada e libere uma preparação completa com os melhores professores do Brasil.

Uma Analista de um Tribunal Regional do Trabalho está conduzindo um diagnóstico demográfico de trabalhadores de diversos setores. Ela possui o arquivo trabalhadores.csv, que contém as colunas nome, idade, ocupação e salario. Antes de calcular a média de idade, a Analista precisa garantir que:
• Todos os registros com idade nula ou negativa sejam desconsiderados do cálculo;
• Apenas trabalhadores cuja ocupação seja diferente de “Estagiário” sejam considerados;
• A média de idade seja calculada com base nesse conjunto de dados filtrado.
Ela inicia o trabalho com o código Python abaixo.
import pandas as pd
df = pd.read_csv('trabalhadores.csv')
df_filtrado = __I__
media_idade = __II__
print (media_idade)
Considerando as condições estabelecidas e o uso adequado das ferramentas da biblioteca Pandas em condições ideais, as lacunas I e II devem ser preenchidas, correta e respectivamente, com: