







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Em bancos de dados relacionais que utilizem a linguagem SQL (não procedural) a otimização de comandos SQL é um fator central no “tuning” de um banco de dados.
A otimização foca na determinação do modo mais eficiente para obter o resultado. Nesse contexto, o “estimator” é o componente que avalia o consumo de recursos num certo plano de execução.
De acordo com o que é preconizado pela Oracle, os fatores pelos quais o custo é estimado são:
Cardinality, Cost, Selectivity.
Disk memory, Indexes, RAM memory.
Filters, Partitions, Primary keys.
Indexes, Join operations, Size.
Joins, Projections, Selection.
No contexto da tabela IPCA apresentada, assinale o comando SQL que produz, corretamente, para cada ano, o mês com o maior índice, ou meses, pois pode haver empate entre os índices de dois ou mais meses num mesmo ano.
select *
from ipca
where exists
(select mes, ano from ipca x
where x.ano = ipca.ano
and x.indice > ipca.indice
group by ano)
order by ano, mês
select ano, mes
from ipca
where not exists
(select mes, ano from ipca x
where x.ano = ipca.ano
and x.indice > ipca.indice)
order by ano, mês
select ano,
mes from ipca
where not exists
(select mes, ano from ipca x
where x.ano >= ipca.ano
and x.indice < ipca.indice)
order by ano, mês
select ano, mes
from ipca
where exists
(select * from ipca x
where x.ano = ipca.ano
and x.indice = ipca.indice
group by mes)
order by ano, mês
select ano, mes
from ipca
where exists
(select mes, ano from ipca x
where x.ano = ipca.ano
or x.indice > ipca.indice)
A otimização de consultas em sistemas de bancos de dados relacionais envolve melhorar o desempenho das consultas SQL para garantir uma execução eficiente. Isso inclui ações como a escrita eficiente e reescrita de consultas, análise de plano de execução, manutenção de estatísticas de tabelas, entre outras. O objetivo é minimizar o tempo de resposta e maximizar o desempenho geral do sistema.
No contexto de otimização de consultas, assinale a opção que indica uma equivalência que não é verdadeira.
δc (R ⋈ S) ≡ ( δc (R)) ⋈ S sendo que a condição C envolve apenas atributos da relação R.
δc1 ((δc2(R))≡δc1 OU c2(R) sendo c1 e c2 são condições lógicas, e R, uma relação.
πA1,A2(δC(R))δC(πA1,A2(R)) , sendo c é condição, e A1 e A2, atributos.
πL1(πL2(πL3(R)))≡πL1(R) , sendo L1, L2 e L3 listas de atributos de R, e L1 ⊂ L2 ⊂ L3.
R ⋈(S ⋈ T)≡(R⋈S)⋈ 𝑇, sendo R, S e T, relações.
O uso otimizado de dados pode melhorar o desempenho da consulta, reduzir o consumo de recursos e aumentar a eficiência geral do sistema. Neste contexto, O nome dado ao processo que envolve a configuração e ajuste de vários parâmetros e estruturas para otimizar o desempenho do banco de dados é.
Underfitting.
Overfitting.
Oversampling.
Tuning.
Triggers.
A característica de servidores de alta disponibilidade que permite alternar perfeita e automaticamente para um sistema de backup confiável em caso de falha do primeiro denomina-se
balanceamento de carga.
elasticidade.
failover.
tailoring.
Em uma empresa XPTO, havia um sistema corporativo interno cujos servidores de aplicação e banco de dados eram hospedados localmente (on-premises).
Os usuários reclamavam da demora em uma consulta específica do sistema ao banco, que durava cerca de 10 a 15 segundos, impactando a produtividade.
Para abordar essa questão, a empresa contratou Joselito, um DBA, com a tarefa de otimizar o desempenho do banco de dados. Ansioso para demonstrar suas habilidades, ele implementou rapidamente uma mudança, esperando melhorar o tempo de resposta.
No entanto, o resultado foi o oposto do esperado: o tempo de resposta da consulta, em vez de diminuir, aumentou para cerca de 300 segundos.
Assinale a opção que representa o comando que foi utilizado por Joselito.
DROP TABLE
DROP INDEX
REBUILD INDEX
VACUUM TABLE
OPTIMIZE TABLE
Para otimizar o desempenho do banco de dados da empresa, poder-se-ia implementar um cache de consultas (caching de consultas) para armazenar os resultados de consultas pouco executadas, reduzindo-se a carga no banco de dados.
Certo
Errado
A consulta
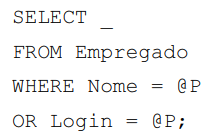
é menos eficiente que a seguinte consulta.
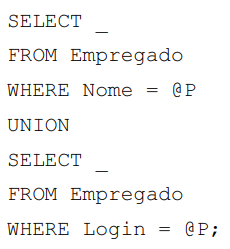
Certo
Errado
A tabela “Tbl_Financeiro” armazena milhares de registros de transações financeiras. Para lidar com consultas que envolvam agregações e cálculos complexos, o administrador de banco de dados poderá adotar a seguinte estratégia de otimização de consultas:
aplicar “commits” aninhados;
utilizar índices bitmap para colunas que envolvam dados calculados;
reduzir a redundância dos dados aplicando técnicas de normalização;
implementar particionamento horizontal para dividir a tabela em segmentos menores;
armazenar previamente os resultados de consultas frequentes utilizando visões materializadas.
O Tuning em Banco de Dados é uma ação que visa a otimização do desempenho da sua infraestrutura de dados. A performance do cache e a redução de paginação é obtida, principalmente, por meio do:
Ajuste de Alocação de Memória.
Ajustes de I/O e Estrutura Física.
Ajustes da Topologia de Acesso.
Ajuste dos caminhos de acessos.
Ajustes das Plataformas.
Para atingir a alta disponibilidade, um sistema deve ser modelado para evitar qualquer tipo de perda de serviço, reduzindo ou gerenciando suas falhas e minimizando o tempo de parada programada. Para minimizar as interrupções não planejadas, deve-se recorrer à redundância de componentes e a recursos de tolerância a falhas. Uma forma de fazer isso para serviços de rede é a implantação de um cluster de servidores de alta disponibilidade.
Nesse tipo de cluster, o failover é o processo de
transição dos serviços de um nó que apresentou alguma falha para outro que assume os serviços.
restabelecimento de aplicações e de recursos de armazenamento no sistema original, depois que o mesmo é reparado.
sinalização contínua do estado de todos os nós do cluster, sendo a ausência da sinalização um indicativo de falha.
agrupamento dos nós do cluster que designam se um serviço pode ou não continuar a sua operação diante de uma falha.
recuperação dos dados perdidos por um nó do cluster após uma falha para que o nó possa voltar a sua operação normal.
Você é um técnico em TI na UFTM e está encarregado de otimizar o desempenho de um banco de dados MySQL que gerencia informações acadêmicas extensas. Após análises iniciais, você percebe que as operações de escrita estão significativamente lentas. Qual das seguintes ações é a mais adequada para realizar o tunning de desempenho do banco de dados para essas operações?
Aumentar o tamanho do InnoDB Buffer Pool.
Desativar o log binário do MySQL.
Alterar as tabelas para o formato de armazenamento MyISAM.
Ajustar o valor da variável max_connections para um número maior.
Para fins de investigação, os auditores da empresa desejam saber os nomes dos clientes que contrataram empréstimos em todas as financeiras.
Assinale a consulta que apresenta o resultado desejado pelos auditores.
select c.nome from tb_cliente c where exists ( select 1 from tb_emprestimo e where e.id_cliente = c.id_cliente )
select c.nome from tb_cliente c where id_cliente = all ( select id_financeira from tb_emprestimo )
select c.nome from tb_cliente c where not exists ( select id_financeira from tb_financeira except select e.id_financeira from tb_emprestimo e where e.id_cliente = c.id_cliente )
select distinct c.nome from tb_financeira f natural join tb_emprestimo e full join tb_cliente c on c.id_cliente = e.id_cliente
select distinct c.nome from tb_financeira natural join tb_emprestimo natural join tb_cliente c
O MySQL Performance Schema é uma das funcionalidades presentes em um servidor MySQL.
Uma das utilidades do MySQL Performance Schema é
rastrear mudanças no esquema de banco de dados.
coletar dados sobre esperas e tempos de espera em mutexes.
registrar o conteúdo dos dados manipulados pelas consultas SQL.
registrar logs de erros do servidor MySQL.
gravar dados em arquivos chamados "instrumentation points."
Assinale a alternativa incorreta no que diz respeito ao bom desempenho de bancos de dados:
A melhoria exata do desempenho dependerá do tamanho do banco de dados e das consultas específicas que estão sendo executadas, mas a indexação pode melhorar significativamente o desempenho do banco de dados.
O uso de um tipo de dados varchar para um campo que deve ser um inteiro pode levar a problemas de desempenho.
Usando as relações um-para-muitos entre as tabelas, podemos escrever consultas eficientes para extrair os dados relevantes com base nas junções entre as tabelas.
Consultas eficientes ocorrem quando uma consulta requer que o banco de dados execute uma grande quantidade de trabalho para recuperar dados.
Ao definir tamanhos de campo, é melhor usar o menor tamanho possível que possa acomodar os dados.
A execução da consulta SQL a seguir listará os nomes dos hospitais que tiveram gastos superiores à média geral de gastos.
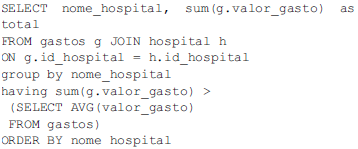
Certo
Errado
Algumas técnicas de otimização automatizada de consultas podem ser aplicadas para melhorar o desempenho das consultas mesmo sem a intervenção do usuário. Sobre a otimização dinâmica de consultas, é verdade que
permitem a escolha das melhores estratégias de acordo com a informação mais recente sobre o banco de dados.
elabora um plano de ação que deve ser seguido em todas as próximas repetições da mesma consulta.
ocorre em tempo de compilação da consulta, sendo processada apenas uma vez pelo SGBD.
armazena um cache com os resultados de consultas anteriores para reduzir o tempo das próximas consultas.
O processo de otimização de um banco de dados, com o objetivo de melhorar o desempenho e a eficiência das consultas, é:
Indexação de Banco de Dados.
Normalização de Banco de Dados.
Recuperação de Banco de Dados.
Segurança de Banco de Dados.
Tuning de Banco de Dados.
Sobre consultas e otimização de consultas no banco de dados oracle 12c, analise as afirmações a seguir:
I-O comando EXPLAIN PLAN é uma instrução que exibe os planos de execução escolhidos pelo Oracle Optimizer para as instruções SELECT, UPDATE, INSERT e DELETE.
II-O comando DISTINCT é utilizado para eliminar duplicidade de registros em uma consulta.
III-A cláusula IN em um comando SQL permite que sejam informados apenas valores fixos e reais. Quando necessário utilizar valores resultantes de subconsultas, é preciso usar a cláusula EXISTS.
É correto o que se afirma em:
I, II e III.
II, apenas.
III, apenas.
I, apenas.
I e II, apenas.
Otimizador de consulta tem por objetivo gerar um plano de avaliação de consulta que calcule o mesmo resultado da expressão analisada.
Certo
Errado



