Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Uma equipe de desenvolvimento precisa consultar a tabela Funcionarios, que possui as colunas id, nome, cargo, salario e departamento_id. O objetivo é retornar todos os funcionários cujo cargo seja "Gerente" e o salário seja superior a 5000, ordenando os resultados do maior para o menor salário. Assinale a alternativa a seguir que mostra a consulta SQL correta para obter esse resultado:
SELECT nome, cargo, salario FROM Funcionarios WHERE cargo = 'Gerente' OR salario > 5000 ORDER BY salario ASC.
SELECT nome, cargo, salario FROM Funcionarios WHERE cargo = 'Gerente' AND salario < 5000 ORDER BY salario DESC.
SELECT nome, cargo, salario FROM Funcionarios WHERE cargo = 'Gerente' AND salario > 5000 ORDER BY salario DESC.
SELECT nome, cargo, salario FROM Funcionarios WHERE cargo = 'Gerente' OR salario > 5000 ORDER BY salario DESC.
Uma das tarefas executadas por Sistemas Gerenciadores de Bancos de Dados, especialmente os relacionais, é a otimização de consultas e operações SQL. Dada uma expressão lógica, especificada por meio dessa linguagem, os gerenciadores buscam estabelecer a melhor estratégia para executar o comando SQL e produzir o resultado desejado.
No contexto da execução eficiente de uma consulta, assinale a definição correta para o conceito de Query Plan (Plano de Consulta).
A execução monitorada da consulta, de modo a identificar um padrão de desempenho em termos de recursos e tempo.
A identificação do conjunto de índices e chaves estrangeiras existentes no banco de dados que podem ser empregados na execução da consulta.
Um conjunto de informações sobre tabelas, índices e ordenações do banco de dados, que possivelmente podem ser empregadas na execução da consulta.
Uma amostra reduzida e representativa dos dados do banco de dados que permite avaliar uma consulta rapidamente.
Uma sequência de operações para a execução da consulta acompanhada de uma previsão de tempo/espaço com os recursos disponíveis no banco de dados.
SQL (Structured Query Language) é a linguagem padrão para a manipulação de dados em sistemas de bancos de dados relacionais, amplamente utilizada em todo o mercado. Embora a sintaxe SQL seja padrão, variações e extensões específicas de cada banco de dados podem existir. Considerando o padrão SQL e suas variações, qual das alternativas a seguir reflete corretamente um aspecto da linguagem SQL padrão?
A função AVG() pode ser usada com a cláusula WHERE para calcular a média apenas dos valores que atendem a um critério específico.
A cláusula INNER JOIN retorna apenas as linhas que possuem correspondências em ambas as tabelas envolvidas na junção.
A função COUNT(*) retorna o número de valores não nulos em uma tabela.
A cláusula HAVING é utilizada para filtrar registros antes de serem agrupados pela cláusula GROUP BY.
A cláusula GROUP BY pode ser utilizada para ordenar os resultados da consulta com base em uma ou mais colunas.
Considere a seguinte sequência de comandos SQL:
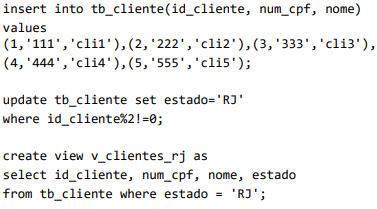
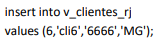
Após a execução dos três comandos SQL apresentados, o seguinte comando foi executado:
![]()
Por fim, a seguinte consulta foi executada:

![]()
O retorno da última consulta executada será

o valor 3, dado que a visão permanece selecionando tuplas de clientes do estado ‘RJ’.
o valor 4, já que a execução do último comando de inserção alterou o estado da visão.
o valor 6, por esse ser o novo número de tuplas da tabela de base da visão.
um erro, pois visões não aceitam inserções diretamente.
uma tabela vazia, pois a última inserção desconfigura a condição-alvo da visão.
Para mostrar a especialidade da psicóloga MARIA DOS ANJOS DA SILVA, é suficiente utilizar a instrução SQL a seguir.
SELECT ESPECIALIDADE
FROM PSICOLOGO
WHERE NOME = ‘MARIA DOS ANJOS DA SILVA‘;
Certo
Errado
Um auditor executou uma consulta SQL e obteve a resposta abaixo:
id_municipio | id_bairro | id_municipio |
10 | 2 | 10 |
15 | 1 | 15 |
Qual das alternativas abaixo representa a consulta SQL executada para obter a resposta acima?
select * from municipios as m left join bairros as b on (m.id_municipio=b.id_municipio)
select * from municipios as m right join bairros as b
select * from municipios as m full join bairros as b on (m.id_municipio=b.id_municipio)
select * from municipios as m full join bairros as b
select * from municipios as m inner join bairros as b on (m.id_municipio=b.id_municipio)
A otimização de consultas SQL é essencial para melhorar o desempenho de sistemas que processam grandes volumes de dados. Análises adequadas permitem identificar gargalos e aumentar a eficiência das operações de leitura e escrita. Qual das alternativas a seguir representa uma técnica eficaz para otimizar o desempenho de uma consulta SQL?
Utilizar subconsultas sempre que possível para dividir o processamento de dados em etapas menores, melhorando a performance.
Evitar o uso de índices, pois eles aumentam o tempo de escrita e podem impactar a performance geral do banco de dados.
Usar funções de agregação em todas as consultas para reduzir o número de linhas retornadas.
Analisar e otimizar o uso de índices e restringir as consultas apenas às colunas e registros necessários.
Usar SELECT * para retornar todas as colunas da tabela, pois simplifica a consulta e reduz a carga no banco de dados.
Considere que todos os dados cadastrados alfabéticos nas tabelas foram armazenados utilizando caracteres maiúsculos.
Analise a consulta SQL padrão ANSI a seguir:
select descricao from tb_contas
where /
Qual das opções completa corretamente o restante da cláusula WHERE acima destacado no comentário /
descricao = '%DESPESA%'
descricao in '*DESPESA*'
descricao is '*DESPESA*'
descricao like '%DESPESA%'
descricao like 'DESPESA'
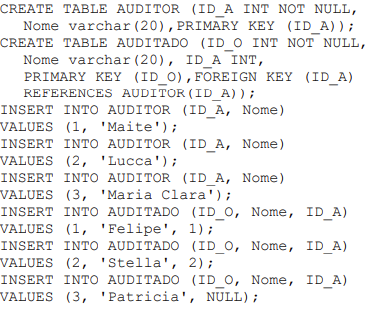
Observe o script SQL a seguir.

Para analisar quais auditores estão realizando auditoria em quais auditados, é necessária a execução de uma consulta SQL que apresente o seguinte resultado:
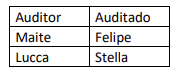
Para obter o resultado apresentado, deve-se executar a consulta SQL:
SELECT AUDITOR.Nome as 'Auditor'
FROM AUDITOR
WHERE AUDITOR.ID_A = ALL
(SELECT AUDITADO.Nome as 'Auditado'
FROM AUDITADO
WHERE AUDITADO.ID_A=AUDITOR.ID_A);
SELECT AUDITOR.Nome as 'Auditor',
AUDITADO.Nome as 'Auditado'
FROM AUDITOR, AUDITADO
HAVING AUDITADO.ID_A=AUDITOR.ID_A;
SELECT AUDITOR.Nome as 'Auditor',
AUDITADO.Nome as 'Auditado'
FROM AUDITOR INNER JOIN AUDITADO ON
AUDITADO.ID_A=AUDITOR.ID_A;
SELECT AUDITOR.Nome as 'Auditor'
FROM AUDITOR
WHERE EXISTS (SELECT AUDITADO.Nome as
'Auditado'
FROM AUDITADO
WHERE AUDITADO.ID_A=AUDITOR.ID_A);
SELECT AUDITOR.Nome as 'Auditor'
FROM AUDITOR
UNION SELECT AUDITADO.Nome as 'Auditado'
FROM AUDITADO;
João está analisando o plano de execução de uma consulta SQL complexa e percebe que o seu desempenho é insatisfatório. Após uma análise detalhada, ele identifica que a consulta está usando, na cláusula “WHERE”, uma função em uma coluna da tabela, o que está afetando negativamente a sua execução.
Com a intenção de melhorar o desempenho da consulta, João deverá:
utilizar um índice bitmap para a coluna em questão;
criar um índice convencional na coluna afetada pela função;
aumentar a alocação de memória para o SGA (System Global Area);
implementar um índice baseado em função (Function-Based Index) na coluna que utiliza a função;
utilizar o Oracle Performance Analyzer para resolver o problema de gargalo de desempenho apresentado.
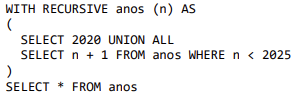
A analista Letícia realizou a seguinte consulta em Structured Query Language (SQL):
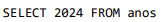
Logo após, Letícia realizou outra consulta em SQL:
![]()
O sistema gerenciador de banco de dados usado por Letícia suporta o recurso Common Table Expression do SQL.
As consultas efetuadas por Letícia retornaram, respectivamente:
uma tupla e um erro;
seis tuplas e um erro;
um erro e duas tuplas;
uma tupla e uma tupla;
seis tuplas e duas tuplas.
O SQL (Structured Query Language) é a linguagem padrão utilizada para manipulação de bancos de dados relacionais. Apesar de ser padronizado, várias implementações de bancos de dados possuem variações, e o conhecimento dessas variações pode influenciar a escolha de comandos e funções. Considerando os padrões de SQL aceitos no mercado, qual das alternativas abaixo está correta?
O FULL OUTER JOIN retorna apenas os registros que têm correspondências em ambas as tabelas envolvidas na consulta.
A cláusula WHERE pode ser usada após a cláusula GROUP BY para filtrar os dados agregados.
A função AVG() retorna a média aritmética, ignorando todos os valores nulos de uma coluna, sem a necessidade de filtros adicionais.
A função COUNT(*) retorna o número total de linhas, incluindo as linhas que possuem valores nulos.
A função COUNT() pode ser usada com a cláusula GROUP BY para retornar a soma de valores de uma coluna em grupos definidos.
Que comando deve ser utilizado para obter o percentual de entradas cujo status é ‘erro’?
select
100*count(*)/(select count(*) from logs)
from logs
where status='sucesso'
select
100*count(*)/(select count(*) from logs)
from logs
where status='erro'
select
100*count(*)/(select count(*) from logs)
from logs
where status<>'erro'
select
100*count(*)/(select count(*) from logs
where status<>'erro')
from logs
select
100*count(*)/(select count(*) from logs
where status='erro')
from logs
where status='erro'
Suponha que durante o projeto de arquitetura de um banco de dados, tenha sido constatado que seu provável uso típico consistiria em consultas segmentadas por datas. Também constatou-se que o volume de dados seria muito alto e que seria necessário realizar ajustes para que as consultas pudessem ser executadas e concluídas dentro de um período de tempo aceitável. Sabendo que o volume de dados é igual todos os dias, assinale a alternativa que corresponde à solução mais adequada para viabilizar o uso do banco de dados no cenário apresentado.
Particionar o banco de dados em partições baseadas nas datas.
Não permitir o uso do comando “join” nas consultas dos usuários.
Implementar consultas utilizando apenas a linguagem de programação C.
Aumentar os recursos disponíveis para o banco de dados de forma ilimitada e indiscriminada.
Liberar o uso do banco de dados apenas em horários de baixa disponibilidade.
Em banco de dados MS Sql Server 2022, em sua configuração-padrão, uma técnica comum para otimizar consultas realizadas frequentemente no banco de dados e que apresentam lentidão, é a de:
criação de índice(s).
criação de chave estrangeira.
duplicação da chave primária.
melhorias no backup e recuperação.
exclusão da chave primária.
ATENÇÃO:
O texto a seguir deve ser usado para as próximas três questões
O esquema de um banco de dados relacional, especificado pelos comandos SQL a seguir, atenderá às consultas
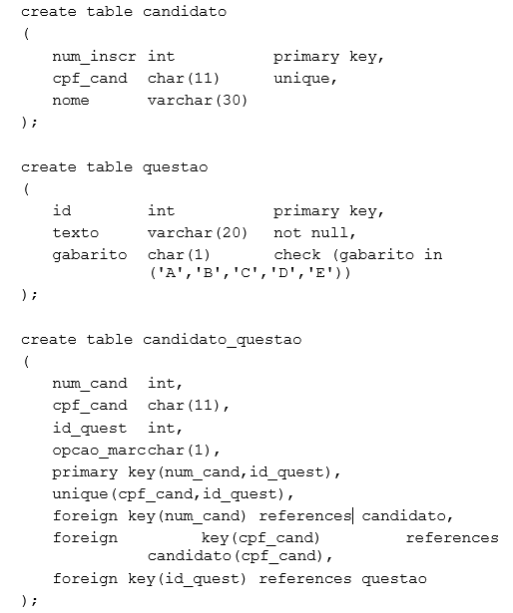
Considere que todos os candidatos que responderam questões tenham suas respostas registradas na tabela
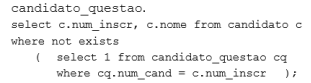
A execução da consulta SQL especificada produz como resultado o número de inscrição e nome dos candidatos que responderam a
alguma questão.
exatamente uma questão.
nenhuma questão.
questões corretas.
todas as questões.
A seguinte consulta SQL lista os hospitais que não tiveram gastos com fisioterapia.
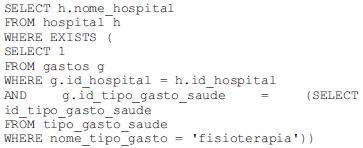
Certo
Errado
10 ms.
20 ms.
11,3 ms.
13,4 ms.
15,1 ms.
São componentes estruturais de um processador:
unidade de controle, unidade lógica e aritmética e unidade de entrada e saída
unidade de controle, unidade de entrada e saída e registradores
unidade de controle, unidade de memória e unidade de entrada e saída
unidade de controle, unidade de memória e registradores
unidade de controle, unidade lógica e aritmética, registradores
As interrupções são decorrentes de eventos assíncronos, o que possibilita a ocorrência de múltiplas incidências simultâneas. Algumas interrupções podem ser ignoradas frente à ocorrência de outras. Essa característica corresponde a
interrupções de buffer.
interrupções mascaráveis.
interrupções spooling.
interrupções não mascaráveis.
interrupções prioritárias.