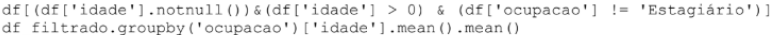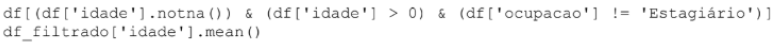Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Considere o seguinte trecho de código em Python, versão 3.12.10, executado no sistema operacional Windows 11 Pro:

CRUZ, F. Python Escreva seus primeiros códigos. São Paulo: Casa do Código, 2021.
Qual das alternativas abaixo representa o que será impresso na tela quando o código for executado?

['Maça', 'Caju', 'Kiwi']
['Laranja', 'Melancia', 'Maça']
['Laranja', 'Melancia']
['Kiwi', 'Caju', 'Maça']
['Melancia', 'Maça']
A linguagem Python oferece diferentes estruturas de repetição para controlar o fluxo de execução de blocos de código. A estrutura “for” é amplamente utilizada por sua simplicidade e legibilidade, especialmente em certos contextos de programação. Com base no comportamento e nas aplicações típicas da estrutura “for” em Python, é adequado utilizar esse tipo de estrutura, EXCETO
quando se deseja repetir indefinidamente até que uma condição seja satisfeita.
quando se conhece previamente o número de vezes que o bloco deve ser executado.
quando se deseja percorrer todos os elementos de uma lista.
quando se deseja iterar sobre os caracteres de uma string.
quando se deseja acessar os elementos de uma tupla em sequência.
Paulo instalou e configurou completa e corretamente o Keras na sua máquina local.
Os comandos Python 3 que ele deve utilizar para verificar a versão instalada são
import keras
print(keras.__version__)
import keras
print(keras.version)
import keras
print(keras,id)
import keras
import gpu
print(keras.id)
import os
import keras
import gpu
print(keras.id.version)
Qual das seguintes opções NÃO é uma estrutura de controle de fluxo em Python?
if.
for.
while.
switch.
else.
Ao executar o programa, será desenhado na tela um:
Quadrado, com cada lado com 200 pixels de comprimento.
Quadrado, com cada lado com 300 pixels de comprimento.
Retângulo, com dois lados com 100 pixels de comprimento e dois lados com 200 pixels de comprimento.
Retângulo, com dois lados com 100 pixels de comprimento e dois lados com 300 pixels de comprimento.
Retângulo, com dois lados com 200 pixels de comprimento e dois lados com 300 pixels de comprimento.
Com base no seguinte trecho de código em Python, que manipula listas e estruturas de repetição, analise as assertivas e assinale a alternativa que aponta as corretas.
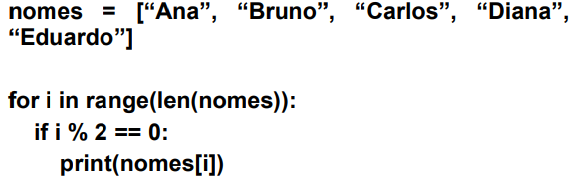
I. O código percorre a lista nomes e imprime todos os elementos.
II. A função range(len(nomes)) gera os índices de 0 a 4.
III. A condição i % 2 == 0 verifica se o índice é par.
IV. Os nomes “Ana”, “Carlos” e “Eduardo” serão impressos.
V. A função print(nomes[i]) imprime diretamente o nome localizado no índice atual.
Apenas I, II e V.
Apenas II, III, IV e V.
Apenas III e IV.
Apenas I, III e IV.
I, II, III, IV e V.
Considere que, na tentativa de calcular a pontuação final de estudantes universitários com base nas suas notas e nos pesos atribuídos às disciplinas, sem usar bibliotecas externas, certo programador tenha desenvolvido o seguinte código em Python.
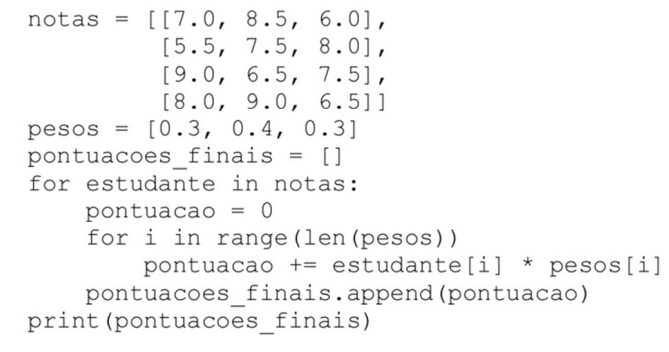
Nessa situação hipotética, a execução do código será bem-sucedida e imprimirá no terminal a lista pontuacoes_finais com as pontuações finais ponderadas para cada estudante.
Certo
Errado
O pacote estatístico Pingouin é recomendado para aplicações estatísticas simples em Python, mas bastante usuais.
Certo
Errado
dados = [3, 7, 0, -1, 7]
resultado = {}
for i in range(len(dados)):
if dados[i] > 0:
chave = f”v_{i}”
if dados[i] not in resultado.values():
else:
resultado[chave] = -dados[i]
elif dados[i] == 0:
continue
else:
resultado[f”neg_{i}”] = abs(dados[i])
print(resultado)
A execução do código Python precedente resulta no trecho a seguir.
{'v_0': 3, 'v_1': 7, 'v_3': -1}
Certo
Errado
O Maple é utilizado para cálculo simbólico, o Mathematica possui capacidades de computação simbólica e numérica integradas, e o R é usado para análise estatística e para visualização de dados.
Certo
Errado
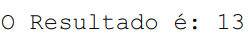
Considere o código a seguir, desenvolvido em Python.
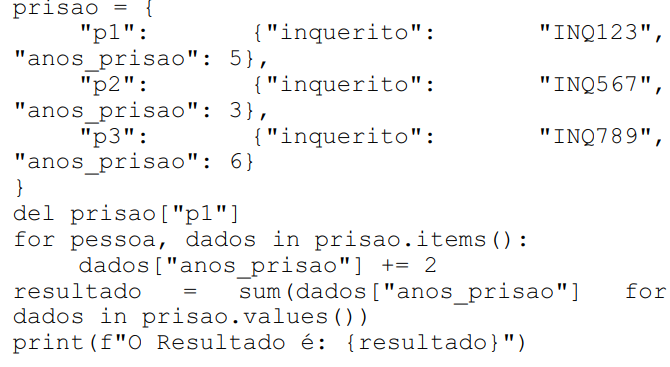
Ao ser executado, esse código apresentará o seguinte resultado.
![]()
Certo
Errado
Em Python, qual é a diferença entre usar == e is ao comparar dois objetos?
== e is são equivalentes em todos os contextos.
is é usado apenas com strings, == com números.
== verifica se são o mesmo objeto, is compara valores.
== compara a equivalência de valores, is verifica se são o mesmo objeto.
O SciPy é uma biblioteca que inclui ferramentas avançadas de aprendizado de máquina, como árvores de decisão, redes neurais e algoritmos de reforço.
Certo
Errado
No contexto da linguagem Python 3, assinale a alternativa que apresenta corretamente o comando para exibir na tela o texto “Bem-vindo ao Python”.
echo(“Bem-vindo ao Python”)
print “Bem-vindo ao Python”
printf(“Bem-vindo ao Python”)
println(“Bem-vindo ao Python”)
print(“Bem-vindo ao Python”)
Uma Analista de um Tribunal Regional do Trabalho está conduzindo um diagnóstico demográfico de trabalhadores de diversos setores. Ela possui o arquivo trabalhadores.csv, que contém as colunas nome, idade, ocupação e salario. Antes de calcular a média de idade, a Analista precisa garantir que:
• Todos os registros com idade nula ou negativa sejam desconsiderados do cálculo;
• Apenas trabalhadores cuja ocupação seja diferente de “Estagiário” sejam considerados;
• A média de idade seja calculada com base nesse conjunto de dados filtrado.
Ela inicia o trabalho com o código Python abaixo.
import pandas as pd
df = pd.read_csv('trabalhadores.csv')
df_filtrado = __I__
media_idade = __II__
print (media_idade)
Considerando as condições estabelecidas e o uso adequado das ferramentas da biblioteca Pandas em condições ideais, as lacunas I e II devem ser preenchidas, correta e respectivamente, com:
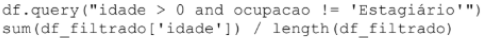
![]()
![]()
![]()
![]()
![]()
O programa em linguagem Python a seguir realiza a tokenização de uma pequena frase.
Descrevendo-o de modo superficial, é implementada nele a importação da biblioteca NLTK (Natural Language Toolkit), que é especializada no tratamento de processamento de linguagem natural.
Para evitar qualquer sobrecarga, é utilizada especificamente a função word_tokenize do submódulo (package) nltk.tokenize da biblioteca nltk.
É definida uma variável do tipo string nomeada como 'texto', que contém a seguinte frase em língua portuguesa: “Tokenização é o processo de dividir textos em unidades menores. Tais unidades são nomeadas como: Tokens”.
A função word_tokenize é utilizada para dividir o conteúdo da variável 'texto' em partes individuais (tokens) as quais são colocadas na lista 'tokens', com o argumento language ='portuguese' especificando que o texto está em língua portuguesa, e assim garantindo que o modelo de tokenizador correto será utilizado.
Ao final, a frase tokenizada é então exibida na tela do usuário.
import nltk
from nltk.tokenize import word_tokenize
texto = "Tokenização é o processo de dividir textos em unidades
menores. Tais unidades são
nomeadas como: Tokens"
tokens = word_tokenize(texto, language='portuguese')
print(tokens)
A quantidade total de tokens exibidos na saída será de
103.
18.
16.
20.
88.
Python possui recursos específicos que facilitam a programação, como o uso de list comprehensions.
Com base nisso, assinale a opção que indica a principal vantagem do uso de list comprehension em Python em comparação com um loop for convencional para criar listas.
É exclusivamente mais rápido em todas as situações, devido à sua implementação interna otimizada.
Resulta sempre em uma sintaxe mais concisa e legível quando comparado a um loop for convencional.
Só funciona para números inteiros, enquanto o loop for pode criar listas a partir de qualquer sequência.
Impede o uso de condições nos laços, enquanto os loops for permitem maior flexibilidade.
É obrigatório no Python para criar listas no caso de grandes quantidades de dados.
Sobre a função train_test_split() da biblioteca scikit-learn, no contexto de aprendizado de máquina em Python, assinale a afirmativa INCORRETA.
Oferece a opção de embaralhar os dados antes da divisão por meio do parâmetro shuffle.
Permite definir a semente do gerador de números aleatórios com o parâmetro random_state.
Pode preservar a proporção de classes em problemas de classificação usando o parâmetro stratify.
Permite configurar a proporção dos subconjuntos através do parâmetro test_size, o qual aceita valores entre 0 e 1.
É capaz de dividir o conjunto de dados em múltiplos subconjuntos, retornando dados de treino, dados de teste e validação, simultaneamente.
Qual linguagem de programação é adequada e amplamente utilizada para tratamento de dados, especialmente em análise de grandes volumes de informação?
Python.
JavaScript.
HTML.
Assembly.
CSS.
Considere o código em Python a seguir.
lista = [14, 57, 8, 14, 25, 57, 25, 57, 89]
saida = dict()
for item in lista:
if item in saida:
saida[item] += 1
else:
saida[item] = 1
print( saida )
Esse código, ao ser executado, apresentará o seguinte resultado.
{14: 2, 57: 3, 8: 1, 25: 2, 89: 1}
Certo
Errado