







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Ao utilizar o algoritmo K-means, a forma mais simples de verificarmos a “qualidade” dos clusters encontrados, a fim de que se possa dizer o quão distantes estão os clusters dos outros, é por meio da:
Distância Euclidiana.
Distância inter-clusters.
Distância entre centroides.
Distância intra-cluster.
Distância entre as médias.
A árvore de decisão é um tipo de algoritmo de aprendizagem de máquina supervisionado, que se baseia na ideia de divisão dos dados em grupos homogêneos, e é utilizado para classificação ou regressão. O objetivo da árvore de decisão é encontrar o atributo que gera a melhor divisão dos dados, isto é, para gerar subconjuntos com maior “pureza”. Selecione a alternativa que NÃO apresenta métrica empregada para a definição do melhor atributo para dividir os dados.
Coeficiente de Gini.
Entropia.
Redução de variância.
Poda de nós.
Observe a tabela abaixo. Cada linha refere-se a uma compra realizada. A tabela tem duas colunas, uma contendo a identificação da compra e outra contendo a lista de itens adquiridos pela compra.
.
Identificação do Compra | Lista de Itens |
01 02 03 04 05 06 07 08 09 10 | A, B, D A, G E, G A, B, D D, F F F, G A, B, C, D C, E A, B |
.
Aplicando o algoritmo de Mineração de Item Sets Apriori, com suporte mínimo de 20%, a lista de itens retornada seria:
A; B; C; D; E; F; G; (A, B); (A, C); (B, C); (A, B, C).
A; B; C; D; E; F; G; (A, B); (A, D); (B, D); (A, B, D).
A; B; C; D; E; F; G; (B, C); (B, D); (C, D); (A, B, C).
A; B; C; D; E; F; G; (A, B); (A, F); (B, F); (A, B, F).
É necessário utilizar um algoritmo de Machine Learning para realizar a classificação de um objeto em três ou mais classes que possuem uma ordem determinada antecipadamente.
Assinale a alternativa que indica corretamente um algoritmo que possa realizar esta tarefa.
Regressão Linear Simples
Regressão Linear Múltipla
Árvores de Regressão Ordinal
Regressão Logísitica Ordinal
Regressão Logística Binomial
Machine Leaming possui um grande conjunto de técnicas e algoritmos consagrados. Por possuírem características específicas, essas técnicas e algoritmos são adequados ou não para a solução de um problema, a depender do tipo de aprendizagem que será utilizado. Marque a alternativa que indica o nome de um algoritmo que NÃO faz parte dos utilizados em cenários onde a aprendizagem supervisionada está presente.
KNN
K-means
Redes Neurais
Árvore de Decisão
SVM
Sobre as redes neurais e de acordo com Haykin (1999), marque a alternativa CORRETA:
Um neurônio artificial é uma estrutura linear. Uma rede neural, constituída por conexões de neurônios, contudo é não-linear. A propriedade da não-linearidade tem suporte para modelagem de fenômenos lineares e não lineares, e assim, a rede neural, pode ser empregada para realizar estimativas ou regressão envolvendo tais fenômenos.
Na aprendizagem com um professor ou aprendizagem supervisionada, o conjunto de dados apresentados para a rede neural deve possuir etiqueta. Esta etiqueta identifica a classificação dos dados, e daí a nomenclatura desta rede neural. Na aprendizagem supervisionada, não há modificação dos pesos sinápticos, isso é desnecessário pois os conjuntos de dados são classificados.
As redes neurais apresentam deficiência em adaptar pesos sintáticos. Com isso, a modelagem de alguns cenários também é prejudicada. Contudo, se forem indicadas estimativas iniciais adequadas para os pesos, a rede neural convergirá para bons resultados.
Um neurônio é uma unidade de processamento de informação, essencial na construção de redes neurais. O neurônio possui três elementos básicos: um conjunto de sinapses ou elos de conexão, um somador e uma função de ativação.
A função de ativação é utilizada para ampliar os valores de entrada em um neurônio. O seu objetivo é aprimorar o funcionamento da rede e contribuir para rápida convergência, e assim, facilitará o cálculo da solução ótima do problema modelado.
Considere as seguintes sentenças:
I - Uma rede neural é um acumulador maciça e paralelamente distribuído, constituído de unidades de processamentos inteligentes, que têm a propensão natural para computar conhecimentos experimentais e torná-los disponíveis para o uso. Ela se assemelha ao cérebro humano.
II - O algoritmo de aprendizagem é um procedimento ordenado, empregado para alterar os pesos sinápticos da rede neural.
III - A generalização é uma propriedade importante e desejada em uma rede neural. Esta propriedade é a característica da rede em produzir saídas apropriadas para valores de entradas que não foram empregados na fase de treinamento.
De acordo com Haykin (1999), marque a alternativa CORRETA:
As sentenças I e II são verdadeiras.
As sentenças I e III são verdadeiras.
As sentenças II e III são verdadeiras.
Todas as sentenças são falsas.
Todas as sentenças são verdadeiras.
No contexto de classificação de padrões, uma abordagem possível é a busca de um hiperplano que melhor separe as classes nos dados de treinamento. A ideia de maximizar a distância desse hiperplano para o ponto mais próximo em cada classe pertence a qual algoritmo?
Arvore de decisão.
Regressão Múltipla.
k-Vizinhos mais próximos.
Máquina de Vetor de Suporte.
Redes Neurais.
Considere, por hipótese, que uma Analista de Sistemas da Câmara Legislativa está participando de um processo de avaliação de quatro softwares concorrentes para suporte a algumas atividades da Câmara. A Analista solicitou que cada empresa fornecesse a função de complexidade do principal algoritmo do software. As funções de complexidade estão listadas abaixo.
I. f(n) = n2
II. f(n) = nlog2n
III. f(n) = 2n
IV. f(n) = 3log2n
Ao fazer a análise dos algoritmos, a Analista conclui corretamente que
para entradas de tamanho n até 1.000 qualquer um dos softwares poderá ser utilizado sem comprometer o desempenho do sistema.
há uma relação de dominação assintótica de um dos softwares sobre os demais e este software que domina assintoticamente os outros não deve ser escolhido, pois pode comprometer o desempenho do sistema.
para entradas de tamanho n acima de 1.000 o software IV é o mais indicado para ser escolhido, pois quanto maior o valor de n, menor o valor do log2n.
para entradas de tamanho n igual ou acima de 1.000.000 qualquer um dos softwares ficará inviável, pois o desempenho do sistema ficará comprometido.
ambos os softwares com funções de complexidade logarítmicas possuem algoritmos ótimos e dominam assintoticamente todos os outros, por isso são as melhores escolhas.
Com o comando de repetição repetir-até-que (repeat-until) pode-se simular o comportamento do enquanto-que (while). Dado o trecho de pseudocódigo esquemático abaixo, assinale a alternativa em que se simula o comportamento do enquanto-que com o repetir-até-que, onde S é uma sequência arbitrária de comandos e C uma expressão boolena que incorpora a condição de parada do laço.
enquanto que C S fim-enquanto |
se C então faça
repita
S
até que C
fim-se
se (não C) então faça
repita
S
até que C
fim-se
se C então faça
repita
S
até que (não C)
fim-se
se (não C) então faça
repita
S
até que (não C)
fim-se
se C então faça
repita
C:=(não C)
S
até que C
fim-se
A figura a seguir ilustra um esquema para execução de programas de computadores.
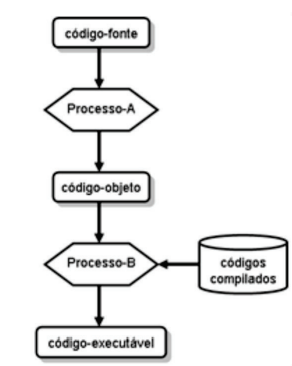
Os processo-A e processo-B são denominados, respectivamente:
compilação e interpretação
codificação e interpretação
compilação e linkedição
codificação e linkedição
Sistemas e técnicas de recuperação da informação, incluindo motores de busca, são voltados para recuperação de informações relevantes. Para isso, utilizam algoritmos de lógica para organização, busca e recuperação da informação.
Sobre a recuperação da informação, assinale a alternativa CORRETA.
Com o surgimento e rápido crescimento da web, a partir da década de 1960, novas aplicações têm surgido enquanto alguns motores de busca dominam o cenário mundial de forma padronizada sem considerar versões adaptadas para cada população.
Alguns motores de busca utilizam técnicas conhecidas de algoritmos de recuperação de informação, mas os mais importantes desenvolvem e implantam os sistemas de recuperação de informação-padrão.
Sistemas de recuperação se espalhou por vários domínios. Originalmente concentrado em textos, tem se expandido para outros meios de comunicação como música, palavras faladas, vídeos, imagens fixas e filmes e multimídia.
Por muito tempo, o input (entrada), com índices e resumos, e o output (saída) eram construídos manualmente. Os esforços para automatizar, tanto a entrada, quanto a saída dos sistemas de recuperação de informação surgiram juntos, levando tempo para serem desenvolvidos e adotados operacionalmente.
O pseudocódigo abaixo representa o algoritmo da função F, que recebe um vetor v como entrada. Esta função usa a função tamanho(v), que retorna o número de elementos do vetor v.
Função F(v)
n <- tamanho(v)
y <- v(1)
para k de 2 até n
se v(k) > y
y <- v(k)
fim se
fim para
retorna y
Esta função calcula a(o)
média dos valores contidos em v.
soma dos valores contidos em v.
mediana dos valores contidos em v.
variância dos valores contidos em v.
maior valor contido em v.
No âmbito dos algoritmos associados ao mining, se houver um banco de dados com um número potencial pequeno de conjuntos de itens grandes, isto é, uns poucos milhares, então o suporte para todos eles pode ser testado em uma passagem usando a técnica específica de
hierarquização.
partição.
amostragem.
árvore de padrão frequente.
séries temporais.



