








Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Uma Secretaria da Fazenda estadual recebeu dados de todos os lançamentos de ICMS dos últimos 5 anos (valores, setores econômicos, municípios, regime tributário e situação do contribuinte). Antes de construir modelos preditivos de risco ou definir novas regras de fiscalização, a equipe decide realizar apenas uma etapa sistemática de resumo, visualização e detecção de padrões e outliers nos dados, sem ainda formular hipóteses formais ou treinar modelos. Esse trabalho inicial e caracterizado como
um exemplo de analytics prescritivo, pois o objetivo principal é recomendar ações específicas de fiscalização para cada contribuinte.
uma etapa de mineração de dados preditiva, focada em gerar automaticamente modelos de classificação de contribuintes de alto risco.
um processo típico de OLAP, em que se navega em cubos com dados consolidados, sem foco em gráficos e exploração detalhada de outliers.
uma etapa de análise exploratória de dados, focada em medidas-resumo e visualizações para entender distribuições e relações entre variáveis.
uma tarefa de aprendizado supervisionado, pois pressupõe rótulos de “fraude” ou “não fraude” para cada lançamento tributário.
Em Python, utilizando bibliotecas de visualização de dados, um setor de fiscalização compara valores de autos de infração por tipo de tributo para identificar assimetria e possíveis outliers de forma padronizada. Nesse caso, a técnica de visualização que atende corretamente ao requisito apresentado é:
Gráfico de área empilhada por tributo, destacando proporções relativas.
Flexplot por dispersão com jitter sem estatística resumida por categoria.
Gráfico de linhas, usando o tipo de tributo no eixo X para sugerir continuidade.
Boxplot por categoria com Seaborn, permitindo comparar quartis e outliers entre tributos.
Gráfico de barras de médias por tributo, pois a média é suficiente para detectar outliers.
Acerca dos princípios e de boas práticas de visualização de dados e painéis de monitoramento, julgue o item a seguir.
Ao olho humano a continuidade da linha é percebida como a progressão do tempo e a conexão entre eventos, de modo que gráficos de linhas são as ferramentas ideais para representar séries temporais.
Certo
Errado
Em se tratando de análises de tendências e projeções, desconsideram-se atributos como sazonalidade, autocorrelação e granularidade temporal quando utilizados modelos estatísticos consolidados.
Certo
Errado
O boxplot (diagrama de caixa) é uma ferramenta de visualização que possibilita identificar a mediana, a dispersão dos dados e a presença de valores atípicos (outliers) em uma distribuição.
Certo
Errado
A análise PCA (análise de componentes principais) é utilizada para simplificar os dados e reduzir o ruído, pois tende a equilibrar as dimensões que têm valores mais extremos (outliers).
Certo
Errado
Uma equipe de ciência de dados do Poder Legislativo desenvolveu um estudo para identificar padrões ocultos em uma base contendo milhares de variáveis derivadas de proposições legislativas, registros de votação, indicadores orçamentários, participação em comissões, frequência de discursos e dados administrativos. Durante a análise exploratória, verificou-se que a elevada dimensionalidade dificultava a visualização dos dados e aumentava o custo computacional de diversas etapas analíticas. Diante desse cenário, foram avaliadas técnicas de redução de dimensionalidade com finalidades distintas de interpretação e exploração dos dados.
Assinale a alternativa que apresenta a interpretação tecnicamente adequada acerca das técnicas PCA e t-SNE.
O PCA e o t-SNE possuem como objetivo principal preservar integralmente todas as variáveis originais, eliminando apenas registros considerados redundantes.
O PCA busca maximizar a separação visual entre grupos previamente desconhecidos, enquanto o t-SNE procura identificar relações lineares entre variáveis independentes.
O PCA utiliza projeções lineares para preservar a maior variância possível dos dados, enquanto o t-SNE enfatiza relações de vizinhança locais para fins de visualização exploratória.
O PCA e o t-SNE produzem componentes interpretáveis diretamente como variáveis originais, permitindo reconstrução sem perda de informação em qualquer cenário.
O PCA é aplicável exclusivamente a dados categóricos, enquanto o t-SNE foi desenvolvido especificamente para conjuntos de dados estruturados em séries temporais.
O storytelling de dados dispensa o uso de visualizações gráficas, pois a narrativa textual é suficiente para transmitir informações complexas.
Certo
Errado
Certo banco de dados no R é constituído de informações sobre adultos, crianças e adolescentes. Após uma consulta ao banco mostrar que algumas pessoas trazem a informação NA (Not Available) no campo idade, qual função exclui os dados dessas pessoas?
> dados < − dados[dim(dados$idade)].
> dados < − dados[head(dados$idade)].
> dados < − dados[summary(dados$idade)].
> dados < − dados[complete.cases(dados$idade)].
O uso do modelo associativo da ferramenta Qlik permite que a INFRA S.A. explore dados de múltiplas fontes sem a necessidade de caminhos de navegação previamente definidos, favorecendo análises exploratórias.
Certo
Errado
Ciência de Dados (CD) utiliza conjuntos de dados para tentar entender e resolver problemas do mundo real. Com relação aos fundamentos essenciais da CD, analise as afirmativas a seguir.
I. Os dados figuram como o elemento central. O objetivo é extrair desses toda informação possível para que se possam tomar decisões e antecipar resultados de maneira precisa.
II. Não é campo de conhecimento alheio às outras ciências. Ao contrário, que se trata de uma combinação de instrumentos fornecidos por diversos campos do saber, com destaque para a Estatística e a Ciência da Computação.
III. CD lida exclusivamente com a análise de dados estruturados, como planilhas e bancos de dados SQL, focando apenas em visualizações básicas e relatórios descritivos.
Está correto o que se afirma em
I, II, III.
II e III, apenas.
I e II, apenas.
III, apenas.
II, apenas.
Uma equipe de ciência de dados da Assembleia Legislativa iniciou o desenvolvimento de estudos voltados à análise de proposições legislativas, indicadores orçamentários e padrões de tramitação. Como parte do processo de trabalho, os analistas passaram a utilizar ambientes de notebook para documentar procedimentos, executar códigos, produzir visualizações e registrar resultados intermediários das análises. A adoção dessa abordagem buscou facilitar a colaboração entre equipes multidisciplinares, aumentar a transparência metodológica e favorecer a reprodutibilidade dos estudos realizados.
Assinale a alternativa que apresenta uma característica tecnicamente associada aos ambientes Jupyter Notebook e Google Colab.
Os ambientes de notebook foram desenvolvidos exclusivamente para execução de consultas SQL, não permitindo integração com bibliotecas estatísticas ou de aprendizado de máquina.
Os ambientes de notebook possibilitam combinar código executável, documentação textual, visualizações e resultados analíticos em um mesmo documento interativo.
Os ambientes de notebook destinam-se exclusivamente ao treinamento de modelos de inteligência artificial, não sendo adequados para análise exploratória de dados.
Os ambientes de notebook substituem sistemas de versionamento de código, eliminando a necessidade de controle histórico das alterações realizadas nos projetos.
Os ambientes de notebook restringem a execução de bibliotecas científicas, sendo utilizados principalmente para armazenamento de dados e documentação institucional.
Uma equipe de análise de dados da Assembleia Legislativa recebeu uma base contendo informações sobre proposições legislativas, execução orçamentária, frequência de participação em comissões, votações nominais e indicadores administrativos. Antes da construção de modelos preditivos, os analistas realizaram um conjunto de procedimentos destinados a compreender a estrutura dos dados, identificar padrões iniciais, verificar distribuições, detectar inconsistências e formular hipóteses para investigações posteriores. Essa etapa foi considerada fundamental para aumentar a confiabilidade das análises subsequentes e reduzir riscos de interpretações equivocadas.
Assinale a alternativa que apresenta uma descrição tecnicamente adequada da finalidade da Análise Exploratória de Dados (EDA).
A Análise Exploratória de Dados tem como objetivo principal substituir a modelagem estatística, produzindo conclusões definitivas sem necessidade de validações posteriores.
A Análise Exploratória de Dados consiste na execução automática de algoritmos preditivos, dispensando a avaliação prévia das características da base utilizada.
A Análise Exploratória de Dados destina-se à compreensão inicial dos dados, permitindo identificar padrões, distribuições, anomalias e possíveis relações entre variáveis.
A Análise Exploratória de Dados limita-se à remoção de registros inconsistentes, não abrangendo atividades relacionadas à interpretação ou visualização das informações.
A Análise Exploratória de Dados concentra-se exclusivamente na construção de indicadores agregados, independentemente das características individuais dos registros analisados.
Analise o notebook abaixo, obtido pela exportação estruturada em texto feita no Jupyter Notebook.
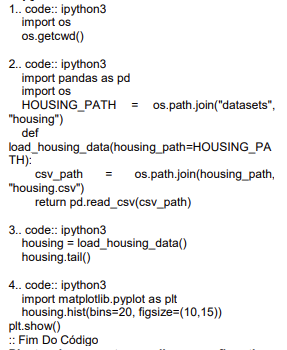
Diante do exposto, analise as afirmativas abaixo.
I. A célula 4 do Notebook gera uma análise descritiva ou resumo dos dados. Para variáveis numéricas obtém-se count, mean, std, min, max, Q1, Q2, Q3. O comando da célula 3 mostra as cinco primeiras linhas do Dataframe.
II. Housing_path é a pasta onde estão os dados no formato <working directory/datasets/housing/>, onde working directory pode ser obtido pelo comando os.getcwd().
III. A função hist() gera histogramas que utiliza a biblioteca matplotlib. Ela utiliza o parâmetro bins, que é a resolução do gráfico, e figsize para o tamanho da figura no formato largura/altura em polegadas.
Estão corretas as afirmativas:
I e II apenas
I apenas
II e III apenas
I, II e III
A AED deve ser concluída antes da modelagem estatística ou do aprendizado de máquina, de forma a não interferir, com redirecionamentos ou revisões interpretativas, no processo posterior.
Certo
Errado
A análise descritiva é responsável por prever eventos futuros com base em dados passados.
Certo
Errado
No processo de exploração de dados, a funcionalidade drill-down retira os dados filtrados por valor ou intervalo.
Certo
Errado
A utilização de gráficos de dispersão e histogramas em grandes conjuntos de dados permite visualizar a distribuição das variáveis e a correlação entre elas; a escolha das variáveis independentes e dependentes influencia a percepção de tendências e padrões.
Certo
Errado
O gráfico de dispersão pode ser uma ferramenta útil para explorar a relação entre as variáveis, possibilitando uma análise visual inicial; no entanto, técnicas adicionais, como suavização por regressão local, transformação de variáveis ou o uso de gráficos alternativos (como histogramas bivariados), podem ser necessárias para revelar padrões mais claramente.
Certo
Errado
Um professor do IFPE é coordenador do projeto de monitoramento do rio Capibaribe em Recife-PE, ele utiliza séries temporais que incluem as variáveis nível_chuva (medido em mm), cota_rio (medido em cm) e turbidez_agua (medido de 1 a 4000 NTUs). Durante a fase de exploração, a equipe de análise de dados constatou que:
● Todas as três variáveis possuem valores ausentes de forma esparsa.
● Existe uma forte correlação multivariada (não necessariamente linear) entre as variáveis. Por exemplo, a cota e a turbidez aumentam significativamente após chuvas intensas.
● A distribuição da variável cota_rio é assimétrica, com a presença de outliers significativos que representam eventos de cheias extremas.
Considerando esse cenário, a equipe decidiu usar uma técnica de imputação. A técnica mais robusta e apropriada para preservar a estrutura e as relações intrínsecas dos dados é:
Imputação pela mediana.
Imputação pela média.
Imputação por um valor constante, como zero.
Imputação por interpolação linear simples.
Imputação usando KNN.



