







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
As árvores de decisão são uma técnica de aprendizado supervisionado que é adequada para analisar, por exemplo, a influência de fatores na qualidade da carne bovina em um sistema de produção, permitindo avaliar variáveis tais como alimentação, genética, manejo e peso ao abate e gerando regras interpretáveis, que auxiliam na tomada de decisão com base nessas características.
Certo
Errado
Considere que se queira aplicar técnicas de processamento de linguagem natural na frase Paulo nasceu no Ceará, de forma tal que Paulo e Ceará sejam considerados, respectivamente, o nome da pessoa e o nome do local de nascimento dela. Nessa situação, é correto utilizar o NER (named entity recognition), pois, por meio da utilização do algoritmo K-means, os grupos relacionados aos termos que se deseja segmentar — no caso, pessoa e local — podem ser encontrados.
Certo
Errado
Em uma rede neural artificial, a função de ativação é responsável por armazenar os pesos de cada conexão entre os neurônios para posterior retropropagação.
Certo
Errado
Os tipos de aprendizado de máquina são categorias que definem como os algoritmos processam e aprendem a partir de dados com a finalidade de realizar tarefas específicas. Eles variam de acordo com o nível de supervisão e a estrutura dos dados disponíveis. Em relação aos tipos de aprendizado de máquina e suas técnicas, informe se é verdadeiro (V) ou falso (F) o que se afirma a seguir e assinale a alternativa com a sequência correta.
( ) No aprendizado supervisionado, os modelos são treinados utilizando dados previamente rotulados, ou seja, entradas que estão associadas às respectivas saídas esperadas.
( ) No aprendizado não supervisionado, os modelos analisam dados sem a necessidade de rótulos pré-definidos, identificando padrões ou agrupamentos existentes nos dados de forma autônoma.
( ) No aprendizado por reforço, os modelos adquirem conhecimento por meio da interação com um ambiente, recebendo recompensas ou penalidades com base nas ações realizadas. O objetivo é maximizar a recompensa acumulada ao longo do tempo.
( ) A análise de associação é um exemplo de aprendizado não supervisionado, enquanto a classificação é um exemplo de aprendizado supervisionado.
V – V – V – V.
V – V – V – F.
V – V – F – F.
V – F – F – F.
F – F – F – F.
Um cientista de dados deseja analisar um conjunto de dados tabular, pré processá-lo e treinar um modelo de rede neural para prever valores contínuos. Ele utiliza Pandas para manipulação dos dados, Scikit-learn para normalização e TensorFlow/Keras para construir o modelo.
Considere o seguinte código em Python:
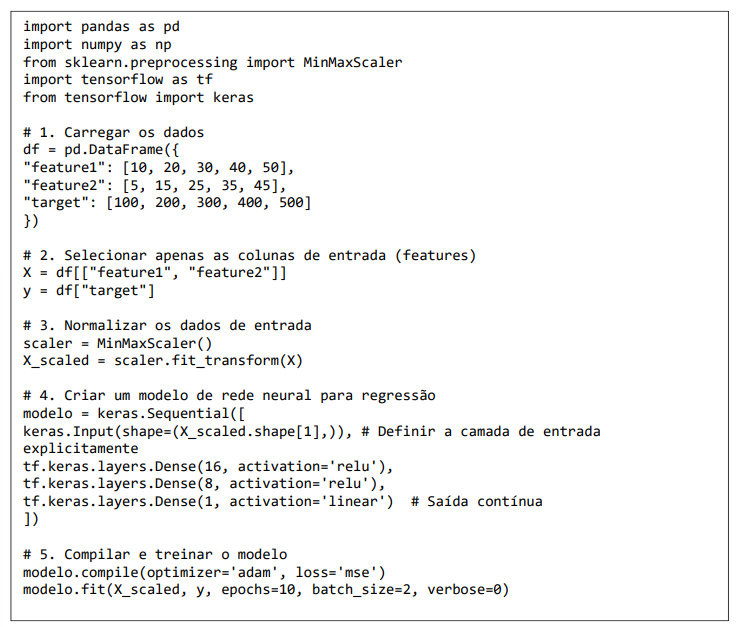
Com base no código apresentado, assinale a alternativa correta sobre a execução e o comportamento desse modelo.
O código implementa um modelo de classificação, pois a ativação linear na última camada indica que a saída será categórica.
A normalização dos dados de entrada não é necessária para redes neurais, pois o algoritmo Adam, já ajusta os pesos automaticamente.
A arquitetura do modelo está incorreta, pois redes neurais para regressão devem sempre conter uma camada de ativação softmax na saída.
O código cria um modelo de aprendizado profundo para regressão, onde os valores de entrada são normalizados e a saída é uma variável contínua, tornando adequada a ativação linear na última camada.
O código não funcionará corretamente, porque a normalização MinMaxScaler não é compatível com redes neurais em TensorFlow/Keras.
Machine learning é sempre supervisionado e não pode funcionar com dados não rotulados.
Certo
Errado
A análise preditiva, uma subárea de IA, utiliza algoritmos estatísticos e de machine learning, para prever eventos futuros com base em dados históricos.
Certo
Errado
A regularização L2 (ridge) reduz a magnitude dos coeficientes sem anulá-los completamente, o que pode mitigar o overfitting, mas não realiza seleção automática de variáveis.
Certo
Errado
Os sistemas que empregam o Aprendizado de Máquina promovem funcionalidades inteligentes para seus usuários. Nesse contexto, existem diferentes tipos de aprendizado. Diante do exposto, assinale a alternativa CORRETA.
O aprendizado por rotulação caracteriza-se por treinar com entradas que possuem saídas conhecidas.
O aprendizado semi-supervisionado é conhecido por receber dados sem rótulos e buscar um equilíbrio ao tentar descobrir padrões ou estruturas ocultas por conta própria.
O aprendizado por reconhecimento é conhecido por aprender a partir de tentativa e erro, interagindo com um ambiente e recebendo recompensas ou punições com base em suas ações.
O aprendizado por transferência caracteriza-se pelo reaproveitamento do conhecimento adquirido em uma tarefa em outra tarefa relacionada, sendo empregado quando há poucos dados disponíveis para o novo problema.
A correta execução de bibliotecas de inteligência artificial que utilizem aceleração por GPU, como TensorFlow ou PyTorch com suporte CUDA, depende da compatibilidade entre as versões da GPU NVIDIA, do driver instalado, do CUDA Toolkit e da biblioteca utilizada, visto que uma incompatibilidade entre esses componentes pode impedir o uso da GPU, mesmo que ela esteja fisicamente instalada e funcional.
Certo
Errado
Suponha que você viajou para Manaus e em um dia agitado, utilizou 4 táxis para seu transporte. Na conversa com o motorista, você pergunta para que time ele torce e os quatro taxistas afirmam torcer para o mesmo time. Você pode ficar tentado a dizer que todos os taxistas de Manaus são torcedores desse time. Esse tipo de generalização em aprendizado de máquina é chamado de “Overfitting”. Com relação à Overfitting, analise as afirmativas abaixo.
I. Uma possível solução para Overfitting é usar um modelo mais complexo, selecionando um com mais parâmetros, por exemplo, um modelo polinomial de alto grau, aumentando o número de atributos dos dados de treinamento.
II. Em árvores de decisão, o Overfitting pode ser contornado, gerando árvores com o maior número possível de nós terminais, resultando em que cada elemento do conjunto de treinamento seja classificado perfeitamente e consequentemente com maior variância.
III. A Regularização é um conjunto de técnicas que ajustam os modelos de regressão com uma função de perda que contém um termo de penalização.
Estão corretas as afirmativas:
III apenas
I, II e III
I e II apenas
II apenas
Marcelo, auditor especializado em Análise de Dados, está estudando o uso de algoritmos de aprendizado de máquina (Machine Learning) para a detecção de fraudes em contas públicas. Como parte de seus experimentos, ele dividiu seu conjunto de dados em treinamento e teste. Após treinar um modelo, percebeu que os resultados apresentavam indícios de underfitting.
O underfitting ocorre
quando o modelo se ajuste bem ao conjunto de treinamento, mas acaba por capturar não apenas os padrões, mas também os ruídos, comprometendo sua capacidade de generalização.
apenas quando o conjunto de treinamento não contém exemplos de todas as classes, prejudicando o desempenho do modelo em classes minoritárias.
quando o modelo não consegue capturar adequadamente os padrões nos dados do conjunto de treinamento, resultando em um desempenho insuficiente.
quando a taxa de aprendizado do modelo é muito baixa, prolongando por exemplo o tempo necessário para que o modelo convirja.
quando o modelo apresenta uma complexidade muito maior do que o necessário, levando por exemplo ao uso ineficiente de recursos computacionais.
Os algoritmos supervisionados de ML do tipo regressão linear são capazes de prever uma variável dependente contínua usando determinado conjunto de variáveis independentes.
Certo
Errado
A utilização de GPU permite acelerar cargas de trabalho de alta complexidade, superando a capacidade de processamento de CPUs tradicionais para a execução de certas tarefas, como o treinamento de modelos de aprendizado profundo para a análise preditiva de sentenças.
Certo
Errado
Um sistema de inteligência artificial foi desenvolvido para dirigir um veículo em um jogo de corrida virtual. O sistema começa sem conhecimento prévio e não recebe exemplos rotulados de como dirigir corretamente. Durante o aprendizado, ele não identifica ou utiliza padrões da pista ou do comportamento de outros veículos. Sua única fonte de informação são as pontuações: pontos positivos ao manter o veículo na pista e fazê-lo completar voltas, pontos negativos quando o veículo sai da pista ou colide, e bônus quando ultrapassa outro veículo ou completa mais rápido a corrida. O sistema ajusta seu comportamento baseando-se unicamente nessas pontuações recebidas após suas ações.
Na situação hipotética precedente, é caracterizado o aprendizado de máquina
passivo.
por transferência.
supervisionado.
não supervisionado.
por reforço.
Em aplicações modernas de ciência de dados, como reconhecimento de padrões e previsão de comportamento, o aprendizado supervisionado tem se destacado por utilizar conjuntos de dados rotulados para treinar modelos capazes de generalizar para novos exemplos.
Assinale a afirmativa que descreve corretamente uma característica fundamental do aprendizado supervisionado em Machine Learning.
Modelos supervisionados não utilizam dados rotulados, pois aprendem padrões de forma autônoma com base em agrupamentos naturais.
Em aprendizado supervisionado, o modelo é treinado com dados de entrada e suas respectivas saídas esperadas, permitindo que ele aprenda a prever rótulos para novos dados.
O aprendizado supervisionado é ideal apenas para problemas de agrupamento, como segmentação de clientes sem dados prévios.
A principal vantagem do aprendizado supervisionado é que ele não requer validação ou avaliação do modelo, pois a acurácia é garantida pela presença de rótulos.
Técnicas supervisionadas não podem ser aplicadas em regressão, sendo utilizadas exclusivamente para problemas de classificação binária.
A inteligência artificial tem revolucionado os processos de comunicação, especialmente na análise e organização de conteúdos audiovisuais. Soluções baseadas em visão computacional e aprendizado de máquina permitem identificar padrões e gerar insights que otimizam o uso e a distribuição de informações em diversas plataformas.
Com base no texto fornecido, qual das seguintes aplicações de IA é utilizada na análise de conteúdos audiovisuais?
Gerenciamento manual de arquivos de vídeo.
Edição automática de vídeos que contenham narrativas fictícias.
Criação espontânea de conteúdo jornalístico sem revisão.
Transcrição de áudio em texto para arquivamento.
Hiperparâmetros são variáveis de configuração que controlam o treinamento de modelos de aprendizado de máquina (ou, machine learning).
No ajuste de hiperparâmetros, também conhecido como otimização de hiperparâmetros, busca-se:
Identificar e selecionar os hiperparâmetros ideais para uso no treinamento de um modelo de aprendizado de máquina.
Processo de ajuste de hiperparâmetros iterativo, onde se experimenta combinação única e padronizada de parâmetros e valores.
Ajuste de hiperparâmetros somente de modo automatizado, obtendo variáveis de configuração externas que os cientistas de dados usam para gerenciar o treinamento do modelo de machine learning.
Polarizar a função de ganho de um modelo de aprendizado de máquina.
O problema que ocorre quando é empregado o algoritmo de retropropagação gera gradientes extremamente pequenos durante o treinamento é:
Overfitting.
Underfitting.
Exploding Gradients.
Vanishing Gradients.
O sensor de ultrassom é amplamente empregado em projetos de Robótica nas escolas, devido à sua capacidade de fornecer informações fundamentais ao sistema embarcado. Sobre esse dispositivo, assinale a alternativa correta:
Mede a intensidade luminosa refletida por superfícies e compara essas variações para diferenciar áreas claras e escuras, sendo aplicado principalmente em robôs seguidores de linha.
Atua como sensor óptico baseado em emissão e recepção de radiação eletromagnética, realizando a análise espectral da luz refletida e permitindo distinguir diferentes cores de superfícies.
Trata-se de um sensor passivo que capta vibrações sonoras no ar, convertendo-as em sinais elétricos para permitir o reconhecimento de comandos de voz.
Opera por meio da variação de resistência elétrica em função da temperatura ambiente e é empregado para monitorar ou evitar o superaquecimento de componentes.
É um sensor ativo que emite ondas mecânicas, calcula o tempo de retorno após refletirem em um obstáculo e, a partir disso, estima a distância entre o robô e o objeto.



