







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
A fim de se evitar o underfitting, o primeiro passo é treinar os modelos para minimizar o erro de classificação, ou seja, evitar que o modelo não consiga capturar os padrões dos dados de treino.
Certo
Errado
O aprendizado supervisionado analisa dados sem respostas predefinidas, identificando padrões ou categorias de forma autônoma, sem orientações específicas.
Certo
Errado
O algoritmo Naive Bayes é inadequado para, por exemplo, a análise de dados de produção agrícola na previsão da qualidade de grãos de café, pois exige uma independência completa entre variáveis como pH do solo, umidade e temperatura, e não apresenta bons resultados quando essas variáveis são correlacionadas.
Certo
Errado
As Árvores de Decisão são algoritmos de aprendizagem supervisionada usados para classificação e regressão, modelando decisões com base em regras derivadas dos dados. Elas são amplamente utilizadas em diversas áreas, como saúde, finanças e análise de risco.
Como exemplo, considere a Árvore de Decisão (fictícia), a seguir, que classifica pacientes com base no risco de ter um infarto. As decisões são feitas com base em três critérios: idade, peso e se é fumante, ou não.
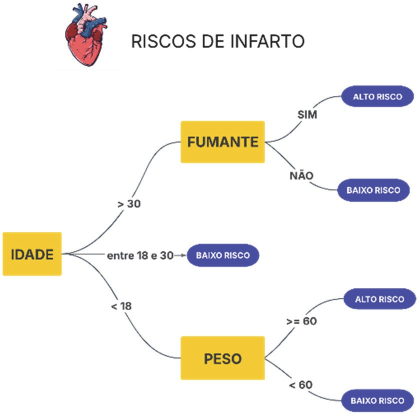
Em relação ao funcionamento das Árvores de Decisão, assinale a alternativa que descreve seu princípio de operação e comportamento na modelagem de dados.
A complexidade da árvore pode ser ajustada para evitar overfitting, garantindo um modelo mais generalizável para novos dados.
As Árvores de Decisão sempre resultam em classificações 100% precisas, pois seguem um conjunto fixo de regras baseadas em dados históricos.
As Árvores de Decisão não podem ser usadas para classificação, apenas para problemas de regressão numérica.
As decisões tomadas pela árvore são baseadas em cálculos probabilísticos de redes neurais profundas.
Quanto mais profunda for a árvore, melhor será seu desempenho, pois ela sempre aprende melhor os padrões dos dados.
Os LLMs se destacaram recentemente em decorrência do aprimoramento das técnicas de treinamento com feedback humano; da maior acessibilidade via interfaces de uso simples como ChatGPT e Gemini; do avanço da potência computacional com GPUs; e da melhoria dos dados de treinamento.
Certo
Errado
O modelo de aprendizado supervisionado ajusta uma função de mapeamento a partir de exemplos rotulados para generalizar dados ainda não vistos.
Certo
Errado
A figura abaixo mostra o comportamento de redes Perceptron de múltiplas camadas. Assim, assinale a opção INCORRETA.
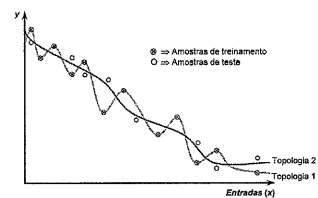
A topologia 1 está operando numa situação de overfitting.
A topologia 2 produz um erro quadrático bem menor frente às amostras de teste.
O erro quadrático produzido pela topologia 1 durante a fase de aprendizado é pequeno.
A topologia 2 está em uma condição de ajuste sem overfitting.
Por conta do underfitting a topologia 1 produzirá respostas de generalização que serão bem mais satisfatórias.
Árvores de decisão são técnicas de modelagem preditiva que particionam iterativamente os dados em subconjuntos homogêneos baseados em variáveis explicativas.
Certo
Errado
A respeito da modelagem centrada em dados (Data-Centric Artificial Intelligence), analise as opções a seguir e marque a correta.
O foco principal está na otimização dos hiperparâmetros aplicados aos modelos de aprendizagem de máquina.
Enfatiza que o design sistemático e a engenharia de dados são essenciais para construir sistemas baseados em IA eficazes e eficientes.
Assume que a coleta de grandes volumes de dados está associada aos benefícios de colocar menos foco no tipo ou qualidade desses dados.
Afirma que os profissionais podem usar aprendizagem de máquina, para resolver problemas únicos, para os quais não existem conjuntos de dados públicos ou modelos pré-treinados adequados.
Entende que apesar da presença de instâncias de baixa qualidade, como rótulos incorretos ou valores imprecisos de características, essas instâncias não precisam ser identificadas e removidas.
A inteligência artificial fraca é capaz de tomar decisões autônomas em contextos diversos, com raciocínio semelhante ao humano, mesmo sem programação específica para cada tarefa.
Certo
Errado
A respeito do conceito e dos tipos de aprendizado de máquinas, qual a alternativa CORRETA?
No aprendizado supervisionado, o modelo deve encontrar padrões e relacionamentos nos dados por conta própria.
No aprendizado de máquina não supervisionado, o modelo de regressão linear é apropriado.
O aprendizado por esforço é um tipo de aprendizado de máquina em que um agente aprende a tomar decisão interagindo com o seu ambiente.
Aprendizado de máquina é independente da inteligência artificial.
Árvore de decisão não é exemplo de algoritmo de aprendizado supervisionado.
Em um projeto de implantação de sistemas de apoio à decisão judicial, a equipe de analistas de um tribunal se depara com a necessidade de avaliar o desempenho de diferentes modelos de aprendizado de máquina. Durante os testes, observa-se que um dos modelos apresenta excelente desempenho nos dados de treinamento, mas performance insatisfatória nos dados de validação. Para diagnosticar e corrigir problemas como esse e selecionar o modelo mais adequado, a equipe deve considerar conceitos como
análise do tempo de processamento em paralelo às métricas de avaliação, priorizando modelos com melhor desempenho computacional em tarefas específicas.
normalização de variáveis de entrada, ajuste de hiperparâmetros e ênfase na acurácia como principal métrica para todos os conjuntos de dados.
overfitting, análise de precisão e recall, uso do F1-score e interpretação da curva ROC.
ampliação do conjunto de treino e avaliação do desempenho com base em métricas simples, como o percentual de acertos em dados conhecidos.
substituição de validação cruzada por divisão fixa dos dados, acompanhada de repetição de testes em conjuntos balanceados.
Um cientista de dados de uma agência reguladora está desenvolvendo modelos de Machine Learning para dois problemas distintos: classificar empresas de alto e baixo risco de fraude focando na Classificação Binária e prever o valor futuro de um indicador econômico tendo por base os fundamentos da Regressão.
Sobre as técnicas de modelagem e avaliação mais adequadas para cada cenário, avalie as afirmativas a seguir.
I. No problema de Classificação Binária com uma base desbalanceada, a métrica do coeficiente de determinação R 2 deve ser priorizada sobre a acurácia.
II. No problema de Regressão, o erro quadrático médio (MSE - Mean Squared Error) é altamente sensível a outliers, e sua raiz quadrada RMSE possui a mesma unidade de medida da variável alvo.
III. O modelo de Regressão Logística é uma técnica de classificação que é adequada para estimar a probabilidade de um evento, mas é incorreto utilizá-lo para prever um valor contínuo como na Regressão.
Está correto o que se afirma em
I, apenas.
I e II, apenas.
I e III, apenas.
II e III, apenas.
I, II e III.
O Aprendizado de Máquina (Machine Learning) é uma das áreas mais importantes e ativas da Inteligência Artificial. Ele permite que máquinas aprendam a realizar tarefas a partir dos dados, sem serem programadas explicitamente para cada situação. A ideia central é aprender com a experiência. Dessa forma, existem alguns tipos de Aprendizado de Máquina, tais como: aprendizado supervisionado, aprendizado não supervisionado e aprendizado por reforço.
Em relação aos tipos de Aprendizado de Máquina, avalie as seguintes afirmações:
I. No aprendizado não supervisionado, o algoritmo aprende com dados rotulados.
Il. No aprendizado supervisionado, o algoritmo agrupa dados com base em similaridade sem rótulos.
IIl. O aprendizado por reforço pode ser usado quando o sistema toma decisões baseadas em interações com o ambiente e feedback em forma de recompensa.
IV. A classificação é uma tarefa adequada para utilização do aprendizado de máquina supervisionado.
Assinale a alternativa que apresenta APENAS as afirmações corretas.
l e ll.
Il e III.
III e IV.
l e III.
ll e IV.
Com o avanço do deep learning, redes neurais profundas e grandes modelos de linguagem (LLMs) vêm sendo amplamente utilizados em aplicações como tradução automática, geração de texto, reconhecimento de imagens e assistentes virtuais.
A respeito de redes neurais profundas, deep learning e grandes modelos de linguagem (LLMs), assinale a afirmativa correta.
Redes neurais profundas possuem apenas uma camada oculta entre a entrada e a saída e são ideais para tarefas simples de classificação linear.
O termo deep learning refere-se a técnicas que dispensam o uso de redes neurais artificiais, utilizando apenas algoritmos estatísticos tradicionais.
Os grandes modelos de linguagem (LLMs) são caracterizados por seu tamanho reduzido, pois dependem de poucos parâmetros para evitar sobrecarga computacional.
Os grandes modelos de linguagem (LLMs) utilizam arquiteturas de redes neurais profundas, como os transformadores, para processar sequências de texto e aprender padrões complexos.
Redes neurais profundas são indicadas exclusivamente para reconhecimento de imagens e não são aplicadas em processamento de linguagem natural.
Uma instituição financeira deseja implementar um sistema de detecção automática de fraudes em transações bancárias, com base em registros históricos rotulados como fraude e transação legítima. O objetivo é classificar novas transações em tempo real.
A técnica de aprendizado de máquina supervisionado mais indicada para esse cenário é:
Árvore de Decisão.
Regressão Linear.
K-means.
PCA (Principal Component Analysis).
DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
Em um problema de classificação binária com aprendizado de máquina, a técnica geralmente mais adequada para ajustar o modelo e evitar o overfitting é
reduzir a quantidade de dados no conjunto de teste.
diminuir o número de dados de treinamento.
utilizar regularização, como L1 ou L2.
aumentar a complexidade do modelo.
evitar o uso de validação cruzada.
O VAE (variational autoencoder) é um autoencoder cuja distribuição de codificações é regularizada somente após o treinamento, o que garante que seu espaço latente tenha boas propriedades e maior dimensão para capturar padrões subjacentes, permitindo a geração de novos dados.
Certo
Errado
Técnicas de machine learning podem ser aplicadas a ambientes de Big Data para detectar padrões e realizar análises preditivas em tempo real.
Certo
Errado
No contexto do deep learning, a função das camadas ocultas (hidden layers) em uma rede neural profunda é extrair e processar os dados de forma que a rede aprenda características progressivamente mais complexas nas camadas mais profundas.
Certo
Errado



