







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
No gráfico XY, são apresentados pontos que representam duas propriedades de elementos de duas classes, R e S. Os pontos da classe R, representados como círculos, são [(3,5),(3,4),(2,3)], enquanto os pontos da classe S, representados como quadrados, são [(4,3),(4,2),(4,1),(3,1),(2,2)]. É necessário classificar pontos novos, de acordo com o algoritmo K-NN, com K=3, considerando a distância euclidiana.
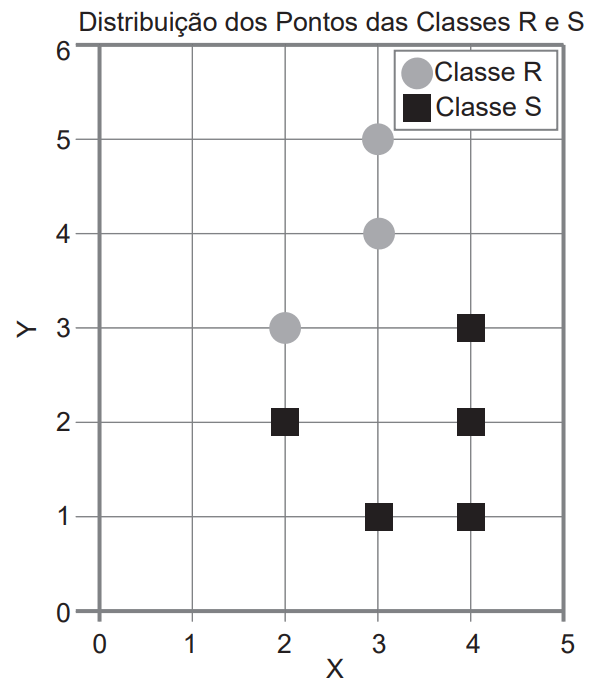
Nesse contexto, as classes dos pontos [(3,2),(3,3) e (4,4)] são, respectivamente:
[R,R,S]
[R,S,R]
[S,R,R]
[S,R,S]
[R,R,R]
Com relação ao aprendizado de máquina, um agente aprenderá a melhorar seu desempenho após fazer observações sobre o mundo. A aprendizagem pode variar do corriqueiro, como anotar uma lista de compras, até o mais profundo, como mostrado por Albert Einstein, que deduziu uma nova teoria para o universo. Quando o agente é um computador, nós o chamamos aprendizado de máquina: um computador observa alguns dados, monta um modelo baseado nos dados e usa o modelo como uma hipótese sobre o mundo e um software que pode resolver problemas. Desta forma, assinale a alternativa que apresenta qual é a principal razão para utilizar aprendizado de máquina em vez de programar um computador com todas as soluções possíveis desde o início.
A necessidade de um hardware mais poderoso para executar algoritmos complexos
A necessidade de reduzir o custo de desenvolvimento do software
A dificuldade de prever todas as situações futuras e a incapacidade dos projetistas de programar todas as soluções manualmente
A impossibilidade de criar interfaces gráficas de usuário eficientes
Assinale a alternativa que apresenta o papel de um prompt na interação com a inteligência artificial (IA) generativa.
Um prompt é um conjunto de algoritmos usados para melhorar a precisão dos modelos de IA generativa
Um prompt é um texto em linguagem natural que orienta a IA generativa a executar uma tarefa específica, gerando novos conteúdos com base em modelos de machine learning pré-treinados
Um prompt é uma interface de usuário que facilita a comunicação entre humanos e sistemas de IA generativa sem a necessidade de linguagem natural
Um prompt é um mecanismo de armazenamento de dados que armazena informações geradas por modelos de IA para posterior análise
A analista Ana está implementando um script para deep learning utilizando o Python e o PyTorch. Considere o seguinte trecho do script de Ana:
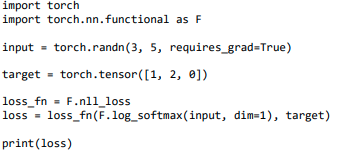
Ao ser executado, o trecho do script acima irá:
imprimir o valor do tensor loss;
falhar, pois a função nll_loss inexiste no PyTorch;
falhar, pois a função log_softmax inexiste no PyTorch;
falhar, pois o valor atribuído à variável input não é um tensor;
falhar, pois faltam informações no valor atribuído à variável target.
Deep learning (aprendizado profundo) é uma subárea do aprendizado de máquina que se concentra em algoritmos baseados em redes neurais artificiais profundas. Essas redes neurais têm várias camadas intermediárias entre a entrada e a saída, permitindo que o sistema aprenda representações de dados em múltiplos níveis de abstração.
Em deep learning, o seguinte conceito se refere ao processo de ajustar os pesos de uma rede neural durante o treinamento, de modo a minimizar a função de perda:
Inicialização de Pesos.
Normalização.
Propagação para Frente (Forward Propagation).
Backpropagation.
Dropout.
A matriz de confusão, em problemas de classificação multiclasses, é uma tabela com duas linhas e duas colunas; na diagonal principal dessa matriz quadrada, estão os valores corretos e, na matriz secundária, os erros cometidos pelo modelo.
Certo
Errado
Em um estudo, foram obtidos dados de expressão gênica de 37.420 genes para um conjunto de 500 amostras de células. O objetivo do estudo é identificar genes que estão envolvidos na regulação de um processo biológico específico e posteriormente induzir um modelo preditivo. As amostras de células foram coletadas de dois grupos de indivíduos, um grupo saudável (400 amostras) e um grupo com uma doença específica (100 amostras). Qual dos seguintes algoritmos de aprendizado de máquina é o mais adequado para extração de um modelo lógico-matemático e indução de um modelo preditivo a partir desse conjunto de dados?
Redes neurais convolucionais.
Regressão logística multinomial.
Redes neurais artificiais feedforward.
DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
Random Forest Feature Elimination.
Em 2014, a arquitetura de redes neurais denominada Redes Adversárias Generativas (GAN) revolucionou o aprendizado de máquina.
As GAN caracterizam-se por
serem usadas, exclusivamente, para classificação de imagens.
consistirem, apenas, em um gerador de ruídos e em uma rede neural classificatória.
serem compostas por duas redes neurais: uma discriminadora e outra geradora.
serem incapazes de aprender a partir de conjuntos de dados não supervisionados.
não poderem ser aplicadas para gerar conteúdo linguístico.
Um algoritmo de aprendizado de máquina é uma técnica que permite que um sistema computacional aprenda a partir de dados, identificando padrões e tomando decisões ou fazendo previsões com base nesses padrões aprendidos. Um algoritmo de classificação
divide o conjunto de dados em grupos que compartilham características.
analisa dados históricos armazenados e prevê comportamentos.
identifica relações entre dados e define regras de associação.
extrai o grau de afinidade entre dados.
Considere certo método de aprendizado de máquina do tipo classificador, para realizar uma tarefa de classificação para k classes (sendo k um número natural maior do que 1) em um conjunto de dados com n objetos (sendo n um número natural maior do que k). Acerca da matriz de confusão correspondente, analise os itens a seguir.
I. A soma de todos os elementos da matriz é igual a n.
II. A taxa de acerto do classificador é dada pela razão entre a soma da diagonal principal da matriz e a soma de todos os elementos.
III. A precisão do classificador para certa classe i é dada pela razão entre o elemento da diagonal principal na linha i e a soma de todos os elementos da coluna i.
Está correto o que se afirma em
I, apenas.
II, apenas.
I e II, apenas.
I e III, apenas.
I, II e III.
BoW (bag of words) é uma técnica de processamento de linguagem natural que transforma um texto em um vetor, considerando a frequência e a ordem ou o contexto das palavras presentes.
Certo
Errado
Support Vector Machines (SVMs) é um método de aprendizado de máquina que pode ser aplicado em áreas como reconhecimento de padrões, bioinformática e detecção de fraudes, devido à sua capacidade de lidar com dados complexos.
Nesse contexto, identificamos que o método SVM
adequa-se a problemas de agrupamento de dados multidimensionais.
apoia-se no princípio do “kernel trick”, que mapeia explicitamente dados não lineares em outros dados lineares.
define margem como sendo a maior saturação de erro (bias) suportada pelo algoritmo na geração de hiperplanos concorrentes.
inviabiliza o uso de abordagens para SVMs lineares com margens rígida e suave para utilização em SVMs não lineares em dados linearmente inseparáveis.
usa um mapeamento não linear para transformar os dados de treino originais em um espaço de dimensão superior.
O Aprendizado de Máquina ou Machine Learning (ML) é uma área da ciência da computação diretamente relacionada à Ciência de Dados (Data Science). Como sua própria terminologia diz, o Aprendizado de Máquina se concentra no desenvolvimento de algoritmos que podem aprender com dados. Seus três principais tipos de algoritmos são Aprendizado Supervisionado, Aprendizado Não Supervisionado e Aprendizado por Reforço.
Com relação aos três tipos de algoritmos mencionados, avalie as afirmativas a seguir:
I. No aprendizado supervisionado, os algoritmos são treinados com dados rotulados, ou seja, dados que contêm exemplos de entrada e saída correspondentes, e, portanto, associam tais entradas às saídas correspondentes.
II. No aprendizado não supervisionado os algoritmos são treinados em conjuntos de dados que não contêm exemplos de entrada e saída correspondentes e, portanto, aprendem a identificar padrões nos dados sem saber o que os seus padrões representam inicialmente.
III. O aprendizado por reforço envolve um agente (softbot) que aprende a tomar decisões em ambientes específicos, interagindo com esses ambientes e recebendo recompensas ou punições por suas ações de exploração ou atuação.
A respeito das afirmações, assinale a alternativa correta.
Apenas as afirmativas I e III estão corretas.
As afirmativas I, II e III estão corretas.
Apenas a afirmativa III está correta.
Apenas a afirmativa I está correta.
Apenas a afirmativa II está correta.
Redes neurais artificiais são elementos fundamentais para o uso de técnicas de aprendizado de máquina. São constituídas por camadas de unidades de processamento, chamadas de neurônios.
Relacione os tipos de redes neurais listadas as seguir, às suas principais características.
1. Redes de Propagação Direta (feedforward).
2. Redes Neurais Recorrentes.
3. Redes de Funções de Base Radial.
4. Redes Auto-Organizáveis de Kohonen.
( ) Rede que possui realimentação, de forma que as saídas são direcionadas para as entradas, formando-se um loop.
( ) Rede em que os sinais fluem apenas em uma direção, da entrada para a saída, exceto quando em treinamento.
( ) Rede que é treinada com aprendizado não supervisionado, criando clusters dos dados de entrada.
( ) Rede usada para aproximar funções contínuas a partir de combinações lineares de Gaussianas.
Assinale a opção que indica a relação correta na ordem apresentada.
2 – 1 – 3 – 4.
3 – 1 – 4 – 2.
1 – 2 – 3 – 4.
2 – 1 – 4 – 3.
1 – 2 – 4 – 3.
Alguns dos primeiros modelos de linguagem de larga escala desenvolvidos tendiam a gerar resultados incorretos com excesso de confiança, caracterizando o que se convencionou chamar de alucinações dos modelos. Uma estratégia de mitigação das alucinações é o uso da técnica de Geração Aumentada por Recuperação, ou Retrieval-Augmented Generation (RAG).
A respeito da RAG, avalie as afirmativas a seguir.
I. Baseia-se na combinação de sistemas de recuperação de informações e de modelos generativos capazes de produzir novos textos.
II. Permite aos modelos buscarem informações relevantes em bases de dados mais confiáveis durante o processamento das consultas dos usuários (user queries), viabilizando melhor adequação a contextos e melhor qualidade das respostas.
III. Não altera os parâmetros dos modelos generativos, e, portanto, não influencia o treinamento das redes neurais com informações recuperadas de bases de dados externas.
Está correto o que se afirma em
I, apenas.
II, apenas.
III, apenas.
I e II, apenas.
I, II e III.
Há uma família de modelos de IA generativa que tem dois modelos treinados em conjunto: o gerador e o discriminador.
O gerador tenta criar dados falsos que sejam indistinguíveis dos dados reais, enquanto que o discriminador tenta distinguir entre dados reais e falsos. O treinamento é um jogo min-max, em que o gerador melhora suas habilidades para enganar o discriminador, e o discriminador melhora suas habilidades para detectar dados falsos.
Assinale a opção que apresenta as características do modelo de IA generativa descritas no texto.
Generative Adversarial Networks.
Variational Autoencoders.
Energy-Based Models.
Autoregressive Models.
Normalizing Flow Models.
Random Forest são algoritmos de aprendizado de máquina utilizados para classificação ou regressão, sendo vantajoso em relação às árvores de decisão no caso de
custo computacional reduzido.
conjunto de dados com propensão a overfitting.
conjunto de dados reduzido.
número elevado de classes.
A aprendizagem é o processo pelo qual os parâmetros livres de entrada de uma rede neural são ajustados a partir do processo de estimulação pelo ambiente na qual a rede está inserida. O tipo de aprendizagem é determinado pela maneira pela qual a modificação dos parâmetros ocorre. A aprendizagem que consiste na minimização da função custo, que é a diferença entre o valor desejado e o valor da saída da rede neural, é conhecida por
aprendizagem por correção de erro.
aprendizagem baseada em memória.
aprendizagem hebbiana.
aprendizagem competitiva.
aprendizagem de Boltzmann.
Na área de Engenharia de Prompt, várias técnicas são usadas para melhorar a capacidade de modelos de linguagem em entender e responder perguntas complexas ou realizar tarefas específicas. Com base na compreensão dessas técnicas, avalie se as seguintes afirmações são verdadeiras (V) ou falsas (F).
( ) Zero-Shot Prompting é uma técnica que requer um grande conjunto de exemplos específicos para treinar o modelo antes de ser capaz de realizar uma tarefa ou responder a uma pergunta.
( ) Chain-of-Thought (COT) envolve instruir o modelo de linguagem para decompor um problema complexo em etapas menores e mais gerenciáveis, detalhando o processo de raciocínio para chegar à resposta.
( ) Few-Shot Prompting utiliza apenas alguns exemplos selecionados para guiar o modelo na execução de uma tarefa, demonstrando como realizar a tarefa com um número limitado de referências.
( ) Zero-Shot COT combina a técnica de Chain-of-Thought com a abordagem Zero-Shot, permitindo que o modelo decomponha e resolva problemas complexos sem a necessidade de exemplos específicos de treinamento prévio.
As afirmativas são, respectivamente,
V – V – V – F.
V – F – F – V.
V – F – F – F.
F – F – V – V.
F – V – V – V.
A biblioteca Scikit-Learn emprega o algoritmo Classification And Regression Tree (CART) para treinar Árvores de Decisão. O algoritmo CART baseia-se na recursividade e na estratégia de divisão binária para construir uma árvore de decisão. Inicialmente, a árvore é representada por um único nó, que contém todos os dados de treinamento. A cada passo, o algoritmo busca a melhor maneira de dividir o conjunto de dados. A recursividade continua até que uma condição de parada seja atendida, como atingir uma profundidade máxima da árvore. Uma vez construída a árvore, a fase de predição ocorre ao percorrer a estrutura da árvore de acordo com as condições estabelecidas nos nós, levando a uma predição (inferência) para uma determinada entrada.
Considerando-se que n corresponde ao número de features e m ao número de instâncias, qual é a complexidade computacional assintótica de predição para árvores de decisão treinadas com o algoritmo CART?
O(m)
O(m2)
O(n × m log(m))
O(n2 × m log(m))
O(log2(m))



