







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
A normalização de um conjunto de dados tem como objetivo representar todos os valores desse conjunto em uma escala de 0 a 1.
Certo
Errado
Relativo às noções de aprendizado de máquina e inteligência artificial, marque a alternativa INCORRETA:
Aplicar técnicas do Aprendizado de Máquina (AM) para se aprofundar em grandes quantidades de dados pode ajudar na descoberta de padrões que não eram aparentes. Isto é chamado de mineração de dados.
Aprendizado de Máquina é fazer com que as máquinas evoluam em algumas tarefas aprendendo com os dados.
No aprendizado não supervisionado, os dados de treinamento que você fornece ao algoritmo incluem as soluções desejadas, chamadas de rótulos.
A classificação é uma tarefa típica do aprendizado supervisionado.
Para implementar inovações no processo de decisão de sentenças judiciais, um analista do TJ-AC decidiu pelo uso da Tradução Automática Neural (do inglês, Neural Machine Translation - NMT) após comparar diferentes técnicas de Processamento de Linguagem Natural (PLN). As vantagens dessa técnica em relação à Tradução Automática Estatística (do inglês, Statistic Machine Translation - SMT) são:
os modelos NMT são mais efetivamente modularizáveis que os SMT e possuem menos parâmetros totais.
os parâmetros do modelo NMT são ajustados independentemente, e o processo pode ser escalonado com o aumento da memória disponível.
os parâmetros do modelo NMT são ajustados conjuntamente e o processo pode ser paralelizado.
os modelos NMT são mais interpretáveis que os modelos SMT e o processo pode ser escalonado com o aumento da memória disponível.
O cientista de dados Pedro trabalha em um projeto que envolve a previsão dos movimentos de um braço robótico em um ambiente complexo. Pedro tem um fluxograma de um algoritmo de aprendizado por reforço que é capaz de se adaptar dinamicamente ao ambiente e ajustar suas ações com base nos resultados de ações anteriores.
O algoritmo representado pelo referido fluxograma que deve ser empregado para a realização da tarefa de Pedro é o:
Máquina de Vetores de Suporte (SVM);
Rede Neural Convolucional (CNN);
Long Short-Term Memory (LSTM);
Twin Delayed Deep Deterministic Policy Gradient (TD3);
K-Vizinhos Mais Próximos (KNN).
No algoritmo K-means, a similaridade intragrupo é avaliada considerando-se o valor médio dos objetos em um grupo, que pode ser visto como o seu centro de gravidade ou o centroide.
Certo
Errado
O pré-processamento é um conjunto de atividades que envolvem preparação, organização e estruturação de dados, sendo fundamental no desempenho do modelo de aprendizagem de máquina. Tais atividades contemplam métodos e técnicas de limpeza, transformação, integração e redução de dimensionalidade. Os métodos que podem ser utilizados para o tratamento de dados faltantes são:
interpolação de vizinhos mais próximos, valor médio do atributo, valor modal.
validação estratificada, k-fold, divisão do conjunto de dados.
validação cruzada, leave-one-out (deixando um de fora), valor mediano do atributo.
divisão do conjunto de dados, gradiente descendente, valor médio do atributo.
A distância de Minkowski entre duas cadeias de caracteres é definida como o número mínimo de operações de edição necessárias para transformar a primeira cadeia de caracteres na segunda.
Certo
Errado
O campo da inteligência artificial generativa é dedicado ao desenvolvimento de algoritmos capazes de gerar novas instâncias de dados. Suas aplicações incluem, por exemplo, a criação de textos, imagens, áudio e vídeo. As redes generativas adversárias (Generative Adversarial Networks – GANs) são um exemplo de IA generativa que possuem arquitetura baseada em duas redes, chamadas geradora e discriminadora, que competem entre si.
Um dos principais problemas das GANs ocorre quando a rede geradora produz apenas uma quantidade limitada de tipos de dados, mesmo que seus dados de treinamento sejam mais ricos e diversificados. Isso ocorre porque a rede geradora consegue “enganar” a rede discriminadora mais facilmente quando dados daqueles tipos específicos são produzidos.
A esse fenômeno dá-se o nome de
Falha de Convergência (Convergence Failure).
Sobreajuste (Overfitting).
Colapso de Modo (Mode Collapse).
Filtragem Estocástica (Stochastic Filtering).
Crescimento de Padrões Frequentes (Frequent Pattern Growth).
No processamento de linguagem natural (PLN), a redução de dimensionalidade é vital para simplificar dados textuais e melhorar o desempenho dos algoritmos de aprendizado de máquina. Diversos métodos são usados para esse fim, cada um com suas próprias características.
Na redução de dimensionalidade em PLN, a técnica utilizada é chamada
Apriori.
K-means.
PCA (Principal Component Analysis).
Redes neurais LSTM (Long Short-Term Memory).
TF-IDF (Term Frequency-Inverse Document Frequency).
As técnicas de aprendizado de máquina aplicadas à assimilação podem ser utilizadas de diversas maneiras para tratamento de dados. Um exemplo de processo que pode ser vantajoso para os algoritmos de assimilação é o de redução da dimensionalidade de um conjunto de dados, no qual se aplica treinamento não supervisionado para gerar representações “compactadas” das entradas originais. Esse processo permite a assimilação de dados no espaço latente, melhorando a eficiência de treinamento dos algoritmos.
Determinadas arquiteturas de rede neural são utilizadas para redução de dimensionalidade e para a geração de representações de dados no espaço latente, em que se destaca a arquitetura do tipo
Autoencoders.
Redes Neurais Bayesianas.
Redes Neurais Convolucionais.
Redes Adversariais Generativas.
Máquinas de Boltzmann Restritas.
Aprendizado de Máquina (Machine Learning) é uma subárea da inteligência artificial (IA) que se concentra em desenvolver algoritmos e modelos que permitem que os sistemas aprendam e façam previsões ou decisões baseadas em dados. O Aprendizado de Máquina pode ser dividido em aprendizado supervisionado, aprendizado não supervisionado e aprendizado por reforço.
No contexto de aprendizado de máquina supervisionado, das técnicas a seguir, a mais apropriada para lidar com um problema de regressão no qual o objetivo é prever um valor numérico contínuo é
a Regressão Linear.
a Regressão Logística.
o K-Nearest Neighbors (KNN) para classificação.
a Support Vector Machine (SVM) com kernel linear para classificação.
a Árvore de Decisão para classificação.
Modelos de aprendizagem de máquina são, em geral, avaliados com métricas que indicam os quão poderosos e relevantes eles são.
Entre exemplos de métricas de avaliação utilizadas para modelos de classificação binária, é correto citar
• a taxa de precisão (razão entre verdadeiros positivos e o total dos verdadeiros positivos e falsos positivos);
• a taxa de sensibilidade (razão entre verdadeiros positivos e o total dos verdadeiros positivos e falsos negativos, também conhecida por recall); e
• o escore F1 (F1-score, também chamado de F-measure), que relaciona as taxas de precisão e de sensibilidade.
Suponha a existência de um modelo de classificação binária cuja taxa de precisão é de 90,00% e cuja taxa de sensibilidade é de 75,00%. Utilize aproximação de duas casas decimais.
O escore F1 referente a esse modelo é
41,42%.
81,82%.
82,15%.
82,50%.
82,84%.
A ferramenta SAS pode ser utilizada para uma ampla gama de tarefas, incluindo-se análise exploratória de dados, aprendizado de máquina, inteligência artificial e mineração de dados.
Certo
Errado
No aprendizado supervisionado, os algoritmos de Naive Bayes e o de máquinas de vetores de suporte são utilizados tanto na classificação quanto na regressão.
Certo
Errado
Alguns trabalhos publicados como notas técnicas pelo Ipea se utilizam do método de classificação denominado de Bayes Ingênuo.
No contexto do classificador Bayesiano Ingênuo, Naive Bayes, a ingenuidade do modelo é caracterizada pela(o)
dependência direta entre todas as variáveis preditoras
ênfase na complexidade do modelo
suposição de independência condicional entre as variáveis preditoras
utilização de distribuição de probabilidade uniforme
uso exclusivo de variáveis contínuas
Uma organização de notícias online quer melhorar sua capacidade de categorizar automaticamente artigos em tópicos relevantes, utilizando uma vasta quantidade de conteúdo textual não estruturado. Qual abordagem seria mais eficaz para organizar automaticamente esses dados e facilitar a busca e recuperação de informações específicas?
Utilização de técnicas de tokenização e análise de frequência de termos para identificar e classificar os tópicos predominantes nos textos.
Implementação de um sistema de gerenciamento de banco de dados relacional para armazenar os artigos e utilizar consultas SQL para classificação.
Aplicação de modelos de redes neurais convolucionais (CNNs) para processar e categorizar imagens associadas aos artigos.
Emprego de algoritmos de aprendizado de máquina não supervisionado, como LDA (Latent Dirichlet Allocation), para descobrir automaticamente os tópicos nos documentos.
Relativo às noções de aprendizado de máquina e inteligência artificial, marque a alternativa INCORRETA:
Árvores de Decisão são algoritmos versáteis de Aprendizado de Máquina que não podem executar tarefas de classificação e regressão.
A redução da dimensionalidade é uma tarefa relacionada na qual o objetivo é simplificar os dados sem perder muita informação.
Gradiente Descendente é um algoritmo de otimização muito genérico capaz de encontrar ótimas soluções para uma ampla gama de problemas.
Uma Máquina de Vetores de Suporte (SVM) é um modelo muito poderoso e versátil de Aprendizado de Máquina capaz de realizar classificações lineares ou não lineares, de regressão e até mesmo detecção de outliers.
O algoritmo Naive Bayes é amplamente utilizado em problemas de classificação, especialmente em aplicações de processamento de linguagem natural e análise de texto.
O princípio fundamental do algoritmo Naive Bayes
baseia-se na técnica de clustering para agrupar instâncias semelhantes.
calcula a média ponderada dos atributos para determinar a classe de um exemplo.
considera a independência condicional entre os atributos dos dados.
utiliza redes neurais profundas para modelar relações complexas entre os atributos.
utiliza uma abordagem de força bruta para encontrar a solução ótima de classificação.
No contexto do aprendizado de máquina, um algoritmo é definido como a especificação de uma relação probabilística existente entre variáveis diferentes.
Certo
Errado
As redes neurais multicamadas usam 3 blocos de camadas. Analise a seguinte figura e assinale a alternativa que corretamente descreve o nome da variável X.
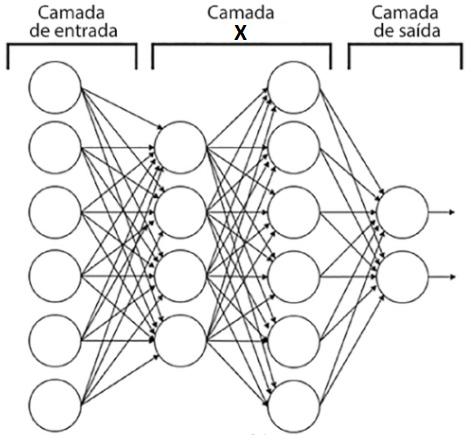
X = Escondida.
X = Neural.
X = Bayesiana.
X = Exponencial.



