







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Apache Spark é frequentemente usado para escalabilidade em ambientes de aprendizado de máquina.
Certo
Errado
A multicolinearidade ocorre quando duas ou mais variáveis independentes encontram-se altamente correlacionadas, causando instabilidade na estimação dos parâmetros e pode comprometer a interpretação dos modelos de regressão. Uma técnica alternativa para lidar com a multicolinearidade é a
análise de componentes principais.
regressão logística.
análise multivariada.
função não linear.
A gestão eficiente de recursos como CPU e memória não é uma consideração crítica em pipelines de aprendizado de máquina, pois os recursos podem ser alocados dinamicamente, conforme necessário.
Certo
Errado
Máquinas de vetores de suporte (do inglês, Support Vector Machine - SVM) são algoritmos de aprendizado de máquina que possibilitam a implementação de classificadores. Os modelos implementados a partir desses algoritmos utilizam funções kernel, conferindo como vantagem:
ausência da necessidade de pré-processamento.
minimização da margem entre as classes.
aumento do grau de especialização no aprendizado.
capacidade de lidar com dados não lineares.
A divisão dos dados por ocasião das tarefas de aprendizado de máquina deve ser feita com todo critério técnico para evitar problemas nos modelos gerados.
No contexto dessa divisão dos dados, assinale a afirmativa correta acerca do processo de overfitting em aprendizado de máquina.
O modelo generaliza bem para dados novos, apresentando baixa taxa de erro tanto em dados de treino quanto em dados de teste.
O modelo se ajusta excessivamente aos dados de treino, mas apresenta baixo desempenho em dados de teste.
O modelo apresenta alto desempenho em dados de teste, mas baixo desempenho em dados de treino.
O modelo é incapaz de aprender padrões dos dados de treino, resultando em alto erro de treino e de teste.
O modelo é robusto e apresenta desempenho constante independentemente do conjunto de dados analisado.
O reconhecimento facial por imagens nas redes sociais é embasado no aprendizado de máquina chamado deep learning, que simula a rede neural do cérebro humano.
Certo
Errado
Qual dos seguintes conceitos é fundamental para o desenvolvimento de sistemas de Inteligência Artificial (IA) que podem aprender e se adaptar com base em dados?
Algoritmos de criptografia.
Redes de computadores.
Aprendizado de máquina.
Linguagens de programação orientadas a objetos.
Um pesquisador de ciência de dados foi encarregado de analisar a capacidade de um modelo de aprendizado de máquina em prever se um cliente é bom pagador. Para isso, possuía um conjunto de dados de testes rotulado, sobre o qual aplicou o modelo e obteve a matriz de confusão a seguir:
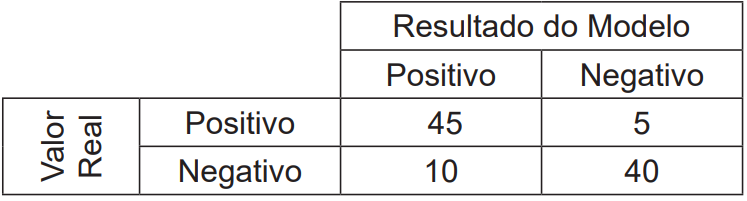
Considerando-se esse contexto, quais são, respectivamente, os valores aproximados, em 2 casas decimais, da precisão (precision) e da revocação (recall) obtidos pelo modelo?
0,82 e 0,85
0,82 e 0,90
0,85 e 0,90
0,90 e 0,82
0,90 e 0,85
A camada de uma rede convolucional que tem como função primária reduzir progressivamente o tamanho espacial do volume de dados de entrada por meio do mapeamento de seções de features e diminuição dos pesos de treinamento é denominada camada de
convolução.
ativação.
pooling.
normalização.
A IA generativa utiliza modelos de base treinados para realizar tarefas gerais, como, por exemplo, técnicas de distribuição de probabilidade.
Certo
Errado
Considere que, durante o processo de treinamento de um modelo de aprendizagem de máquina, tenha ocorrido sobreajuste (overfitting) dos dados. Acerca dessa situação hipotética, julgue os itens a seguir.
I Os dados utilizados durante o treinamento possuem grande quantidade de informações irrelevantes.
II O modelo utilizado é de baixa complexidade e aprendeu o ruído nos dados de treinamento.
III A validação cruzada K-fold é um dos métodos que podem ser utilizados na detecção da ocorrência de sobreajuste.
Assinale a opção correta.
Apenas o item I está certo.
Apenas o item II está certo.
Apenas os itens I e III estão certos.
Apenas os itens II e III estão certos.
Todos os itens estão certos.
Aprendizado de máquina e mineração de dados são termos idênticos em relação aos seus objetivos e funções, pois ambos lidam com algoritmos de inteligência artificial para padrões em grandes conjuntos de dados em busca de conhecimento.
Certo
Errado
Visando a maximizar a eficiência de uma equipe de auditores fiscais, um sistema de classificação de documentação foi encomendado à equipe de ciência de dados, com o objetivo de decidir, com base nos documentos obtidos durante uma fiscalização, se um exame detalhado de documentação é ou não necessário.
Idealmente, o sistema permitiria aos auditores direcionar mais tempo às auditorias complexas e agilizar a análise dos casos mais simples, otimizando o custo de pessoal e equipamento especializado. Contudo, não examinar detalhadamente um caso complexo pode custar muito caro ao governo, a ponto de anular quaisquer ganhos obtidos usando o sistema com um pequeno número de erros.
Considerando esse cenário, e o fato de o sistema de classificação responder apenas “sim” ou “não” quanto à necessidade de exame detalhado, a métrica de classificação a ser maximizada pela equipe que irá implementar o sistema é:
acurácia;
revocação;
F1-score;
precisão;
AUC.
O aprendizado não supervisionado é uma área da inteligência artificial que envolve o uso de algoritmos para encontrar padrões ocultos em conjuntos de dados rotulados.
Certo
Errado
A técnica da árvore de decisão utiliza, entre outras, a abordagem de predição, na qual grupos diferentes são identificados de acordo com características em comum.
Certo
Errado
Stemming é uma técnica que reduz palavras flexionadas ao seu radical, permitindo que as variações de uma palavra sejam tratadas como um mesmo termo, o que melhora o desempenho de modelos de aprendizado de máquina.
Certo
Errado
Modelos generativos tentam modelar como os dados foram gerados, ou seja, eles aprendem a distribuição conjunta P (X, Y), onde X são as características e Y são os rótulos, enquanto, modelos discriminativos tentam modelar a fronteira de decisão entre diferentes classes. Eles aprendem a distribuição condicional P(Y∣X), ou seja, a probabilidade de um rótulo dado um conjunto de características. Desta maneira, assinale a alternativa que apresenta qual categoria se enquadra o algoritmo Naive Bayes.
Generativos
Discriminativos
Regressivos
Decisivos
Aprendizado de máquina (Machine learning) e aprendizado profundo (Deep learning) são assuntos populares nos dias de hoje na área da computação. Assinale a alternativa que apresenta a principal diferença entre aprendizado de máquina e aprendizado profundo.
Aprendizado de máquina usa apenas análise estatística, enquanto aprendizado profundo usa redes neurais
Aprendizado de máquina é baseado em múltiplas técnicas, enquanto aprendizado profundo imita a funcionalidade do cérebro humano usando redes neurais
Aprendizado de máquina é menos eficaz do que aprendizado profundo
Aprendizado profundo depende de intervenção humana, enquanto aprendizado de máquina é totalmente automatizado
A regressão linear do aprendizado de máquina busca estabelecer uma relação entre as variáveis de entrada de um algoritmo.
Certo
Errado
Machine learning (aprendizado de máquinas) é uma área da inteligência artificial que objetiva desenvolver algoritmos e modelos computacionais capazes de aprender e aprimorar seu desempenho por meio da experiência com dados. Esses sistemas utilizam técnicas estatísticas e de análise de dados para identificar padrões, tomar decisões e fazer previsões; a essência do aprendizado de máquina é permitir que elas se adaptem e evoluam com base em informações e experiências passadas, tornando-se capazes de realizar tarefas específicas de forma mais eficaz e precisa. NÃO é um tipo comumente reconhecido de aprendizado de máquina o aprendizado
profundo.
por reforço.
de memória.
supervisionado.



