








Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Acerca das regras de associação e do aprendizado não supervisionado por meio da biblioteca Scikit-learn do Python, assinale a opção correta.
No algoritmo Apriori, parâmetros como suporte mínimo e confiança são fundamentais para filtrar e determinar a relevância das regras geradas.
Regras de associação são aplicáveis nos modelos de aprendizado supervisionado e somente em um modelo de aprendizado não supervisionado.
O aumento dos valores de suporte mínimo e confiança no algoritmo Apriori tende a aumentar o número de regras geradas.
O Scikit-learn possui implementação nativa para a extração de regras de associação com base no algoritmo Apriori.
A métrica lift é utilizada apenas para calcular a frequência dos itens no conjunto de dados, de modo que não é útil para avaliar a relevância das regras geradas.
A regra do cotovelo é uma técnica visual amplamente utilizada para identificar a quantidade ideal de agrupamentos que melhor representam os dados, sendo especialmente aplicada em qual método de clusterização?
CNN
KNN
DBScan
K-Means
O analista de Business Intelligence Luiz está desenvolvendo uma solução aplicando técnicas de mineração de dados na base de dados de processos judiciais do MPU para descobrir padrões que mostrem resultados como o exemplificado a seguir.
{Roubo, Antecedentes Criminais, RJ, 2024} ➔ {Pena > 5 anos} [Suporte = 50%, Confiança = 80%]
Para descobrir esse tipo de padrão, com antecedente e consequente, Luiz deve minerar:
clusters;
outliers;
anomalias;
regressões;
regras de associação.
Em data mining, a técnica de regras de associação é usada para prever valores contínuos com base em atributos independentes, utilizando-se árvores de regressão.
Certo
Errado
Segundo Barbieri (2011), a árvore de decisão é uma técnica utilizada em Data Mining. Assinale a opção que apresenta corretamente a abordagem empregada na utilização dessa técnica correspondente à criação de regras para aplicação em eventos futuros.
Estratificação.
Identificação de Interações.
Predição.
Redução de Dados.
Segmentação.
Considere o seguinte conjunto de transações em uma loja de varejo:
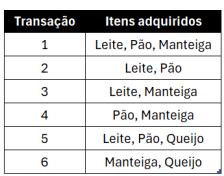
A partir desse conjunto de transações, produz-se a regra de associação R: Leite → Pão
Nesse contexto, é correto afirmar que a métrica de R que possui valor igual a 50% é
a confiança.
o F1 score.
a precisão.
o recall.
o suporte.
Os algoritmos de regras de associação constroem regras com apenas uma única conclusão, ao contrário dos algoritmos de árvore de decisão, que tentam localizar muitas regras, cada uma delas com uma conclusão diferente.
Certo
Errado
No modelo a seguir, que contém regras que incluem os itens A, B, C, D, E, F, G e H, as regras 1 e 2 pertencem a um mesmo grupo de regras.
Certo
Errado
Um sistema de mineração de dados é desenvolvido para ajudar uma rede de hospitais a melhorar a gestão de seus recursos, prever picos de demanda e otimizar a alocação de pessoal e equipamentos. Ao analisar os dados históricos de admissões, quais resultados da mineração de dados seriam mais valiosos para representar o conhecimento adquirido e auxiliar na tomada de decisões?
Modelos de clusters que segmentam os hospitais com base em padrões de admissão, identificando grupos com demandas similares.
Regras de associação que revelam correlações entre os dias da semana e a incidência de certos tipos de emergências médicas.
Árvores de decisão que preveem os volumes de admissão com base em variáveis como época do ano, eventos locais e tendências de doenças.
Redes neurais que estimam a satisfação do paciente com base em avaliações de serviço, auxiliando na melhoria da qualidade do atendimento.
Descobrir regras de associação consiste em analisar as relações entre os atributos de uma base de dados transacional para tentar correlacioná-los.
Sobre regras de associação, assinale a afirmativa correta.
A frequência de um item em uma base de dados não é pertinente para a descoberta de regras de associação.
O Algoritmo Frequent-Pattern Growth é um algoritmo computacionalmente custoso, não sendo apropriado para o uso em bases de dados transacionais extensas.
O suporte de um conjunto de itens mede o tamanho desse conjunto na sua respectiva base transacional.
A adição de um novo item a um conjunto de itens produz um novo conjunto de itens, que poderá ter frequência maior que o conjunto original na sua base transacional.
O Algoritmo Apriori é um algoritmo iterativo usado na descoberta de regras de associação.
A mineração de dados (Data Mining) envolve um conjunto de algoritmos e ferramentas que são utilizados para a exploração de dados, permitindo extrair padrões ocultos de forma automatizada e, assim, gerar informação. Qual método de mineração de dados é utilizado na extração de regras de associação?
Apriori.
C4.5
K-mean.
Naive Bayes.
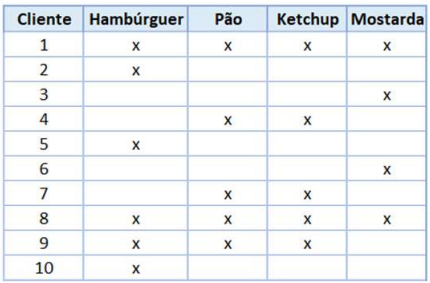
A associação é uma técnica de mineração de dados que possui como princípio a utilização de algumas regras para encontrar relacionamentos entre variáveis, inclusive em situações em que elas, aparentemente, não possuem nenhuma relação. Considerando a realização de compras por 10 clientes como demonstrado abaixo, pode-se afirmar que o valor do suporte e confiança para a associação "hambúrguer e pão" é, respectivamente, de:
40% e 60%.
30% e 50%.
60% e 40%.
50% e 60%.
50% e 50%.
Assim como no caso das outras tarefas de mineração de dados, a mineração de regras de associação também pode ser executada por diferentes algoritmos, sendo que muitos deles são variações e melhorias de um algoritmo pioneiro, o processo geral de minerar regras de associação está dividido em quatro passos. Com relação ao passo de pré-processamento da base, assinale a alternativa correta.
O pré-processamento envolve etapas como: limpeza, integração, redução, transformação e discretização, a preparação de uma base transacional para a mineração de regras pode exigir que essa base seja transformada em uma base binária ou baseada em frequência
O pré-processamento envolve gerar um conjunto de itens frequentes, são aqueles que satisfazem algum critério mínimo de frequência, por exemplo, itens que aparecem ao menos em determinado número de transações
O pré-processamento envolve a criação de regras de associação, estas regras são geradas em uma etapa específica usando apenas os itens frequentes da base
O pré-processamento envolve a criação de regras de associação, que devem ser avaliadas utilizando-se diferentes medidas de interesse, dependendo do contexto



