








Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
A estrutura de controle IF, que pode ser classificada como do tipo iteração, determina o caminho que o algoritmo deve seguir, de acordo com determinada condição.
Certo
Errado
Random forests fornecem pontuações de distância euclidiana entre os recursos que podem ser usadas para compreender a importância relativa de cada recurso na previsão.
Certo
Errado
Analise o algoritmo abaixo, escrito em pseudocódigo (Portugol):
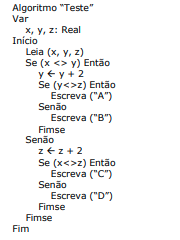
Ao executar o algoritmo acima, o que será exibido caso sejam lidos os valores 4, 4 e 2, nessa ordem?
D
C
B
A
Nenhuma das alternativas anteriores.
Medir a complexidade dos métodos de ordenação é fundamental para entender o desempenho desses algoritmos e poder fazer escolhas adequadas dependendo do contexto do problema. Qual método de ordenação o pior caso tem a mesma complexidade do método Quick Sort no pior caso?
Heap Sort.
Buble Sort.
Merge Sort.
Radix Sort.
Qual é o método de ordenação que percorre a lista de elementos, comparando os adjacentes (pares consecutivos) e trocando-os de posição, caso não estejam em ordem?
Bolha.
Seleção.
Inserção.
Hash.
Sobre classificações de algoritmos, analise as alternativas abaixo e identifique qual delas descreve CORRETAMENTE um tipo específico de algoritmo de acordo com suas características e propósito.
Um algoritmo ganancioso precisa conhecer a solução de todos os subproblemas em cada passo para tomar a decisão mais adequada.
Algoritmos de divisão e conquista lidam com problemas complexos, reduzindo-os iterativamente em subproblemas menores, geralmente utilizando técnicas de programação linear para solucionar cada subproblema.
Algoritmos não-determinísticos sempre retornam o mesmo resultado ao resolver o problema, pois tomam decisões exatas e previsíveis a cada passo.
A programação dinâmica evita o recálculo de soluções de subproblemas já resolvidos anteriormente, armazenando essas soluções para otimizar o tempo de execução.
Um algoritmo serial divide o problema em subproblemas para resolver simultaneamente em diferentes processadores e, em seguida, agrupa os resultados.
Considere uma função f(x) contínua no intervalo [a, b] e que f(a)f(b) < 0. Considere, ainda, a utilização do método da bissecção, para obtenção do zero real desta função, sabendo que o valor de xK, em cada iteração K, é dado por (aK + bK)/2.
Se na primeira iteração for constatado que
f(a0)<0,f(b0)>0 e f(x0)>0
e na segunda iteração
f(a1)<0,f(b1)>0 e f(x1)<0,
na aplicação deste método, devem ser feitas as seguintes atribuições para os novos limites dos intervalos:
a1=b0;b1=a0;a2=b1; e b2=x1.
a1=x0; b1=b0; a2=x1; e b2=b1.
a1=a0; b1=x0; a2=a1; e b2=x1.
a1=a0; b1=x0; a2=x1; e b2=b1.
a1=b0; b1=x0; a2=b1; e b2=x1.
Sobre estrutura de dados e algoritmos, analise as opções a seguir e assinale a INCORRETA:
A pesquisa linear tem complexidade de tempo O(n) no pior caso, sendo adequada para pesquisa em vetores não ordenados ou quando o elemento procurado está próximo ao início do vetor.
A estrutura de dados fila de prioridade é um tipo de estrutura que permite a inserção de elementos com prioridades associadas e a operação de remoção sempre retira o elemento com a maior prioridade.
O algoritmo de ordenação Heap Sort utiliza uma estrutura de dados Heap para ordenar os elementos, com complexidade de tempo O (n log n ) no pior caso e sendo um algoritmo de ordenação in-place, ou seja, não requer memória adicional significativa além da utilizada para armazenar os dados originais.
O algoritmo de ordenação Radix Sort é um algoritmo de ordenação por comparação, com complexidade de tempo O ( n log n ), que ordena os elementos com base em seus dígitos individuais.
A estrutura de dados Trie é uma árvore de prefixos utilizada para armazenar um conjunto de strings, permitindo a busca eficiente de uma string em tempo proporcional ao seu comprimento, independentemente do tamanho do conjunto de strings armazenado.
A teoria dos autômatos é uma área da ciência da computação que utiliza conceitos matemáticos para estudar modelos abstratos de máquinas computacionais. Considere os tipos de autômatos e suas capacidades. Qual das afirmativas abaixo é correta?
Um autômato finito determinístico (DFA) pode reconhecer qualquer linguagem regular.
Um autômato de pilha (PDA) é capaz de reconhecer todas as linguagens regulares e algumas linguagens não regulares.
Máquinas de Turing podem reconhecer apenas linguagens contextuais.
Um autômato finito não determinístico (NFA) tem menos poder de expressão do que um DFA.
Os fluxogramas são ferramentas gráficas utilizadas no desenvolvimento de algoritmos para representar visualmente o processo de execução de um código. Eles são amplamente adotados devido à sua capacidade de oferecer uma visualização clara dos passos de um processo, sendo assim mais facilmente compreendidos por diferentes profissionais, inclusive aqueles fora da área de programação.
Certo
Errado
A programação de um sistema computacional requer conhecimento de algumas estruturas e conceitos, importantes presentes nas linguagens de programação. Associe as duas colunas, relacionando os termos as suas definições.
1 - Estrutura de Dados.
2 - Algoritmos.
3 - Compiladores.
4 - Estruturas de Repetição.
( ) Sequências de instruções ou comandos realizados de maneira sistemática, com o objetivo de resolver um problema ou executar uma tarefa.
( ) São programas que traduzem um programa descrito em uma linguagem de alto nível para um programa equivalente em código de máquina para um processador.
( ) São utilizadas para executar repetidamente uma instrução ou bloco de instrução, enquanto determinada condição estiver sendo satisfeita.
( ) Estuda os diversos mecanismos de organização de dados para atender aos diferentes requisitos de processamento.
A sequência CORRETA, de cima para baixo é:
2, 3, 4, 1
1, 2, 3, 4
1, 3, 2, 4
2, 1, 4, 3
3, 2, 1, 4
Analise o algoritmo abaixo, escrito no software VisuAlg 3.0:
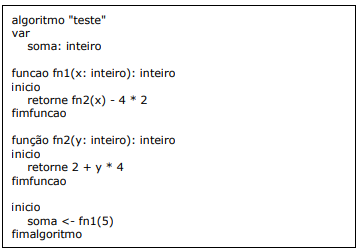
Ao final da execução do algoritmo, qual será o valor da variável "soma"?
5
14
20
36
48
Analise o algoritmo abaixo, escrito no software VisuAlg 3.0:
algoritmo "concurso" var cont1, cont2: inteiro inicio cont1 := 1 enquanto (cont1 <= 3) faca para cont2 de 1 ate 2 faca se cont1 <> cont2 entao escreva("D") senao escreva("I") fimse fimpara cont1 <- cont1 + 1 fimenquanto fimalgoritmo |
O que será impresso a partir da execução do algoritmo?
IDDIDD
IDIDID
IIIDDD
DIDIDI
DDIDDI
Assinale a opção que apresenta a representação correta de instruções, em pseudocódigo tipado, para definir uma variável e modificar e imprimir seu conteúdo em uma saída.
variavel = 0;
variavel = 1 + 2;
imprime(variavel);
inteiro variavel = 0;
variavel = 1 + 2;
imprime(inteiro);
inteiro variavel = 0;
variavel = "1" + "2";
imprime(variavel);
inteiro variavel = 0;
variavel = 1 + 2;
imprime(variavel);
inteiro variavel = "0";
variavel = 1 + 2;
imprime(variavel);
Relacione os algoritmos de escalonamento com suas respectivas definições:
1. FIFO (First in – First out)
2. SJF (Shortest Job First)
3. Round-Robin
4. Múltiplas filas
( ) O escalonador define um quantum (fatia de tempo) para cada processo, que se executa conforme uma lista circular de processos prontos.
( ) Algoritmos não-preemptivo extremamente eficiente, que busca minimizar o turnaround (tempo de espera dos “clientes”) e necessita informações a respeito dos processos e de sua duração.
( ) Algoritmo de prioridade preemptiva no qual são definidas prioridades, estáticas e dinâmicas, para os processos resultando em uma lista por nível de prioridades.
( ) Algoritmos não-preemptivo extremamente simples, onde se atribui o uso da CPU ao processo pronto há mais tempo.
Assinale a opção que indica a relação correta, na ordem apresentada
1 – 4 – 3 – 2.
3 – 2 – 4 – 1.
4 – 1 – 2 – 3.
2 – 3 – 1 – 4.
4 – 2 – 3 – 1.
Todas as probabilidades necessárias para a obtenção do classificador Naive Bayes são computadas a partir dos dados de treinamento. Assinale a alternativa que apresenta o que é necessário para calcular a probabilidade a priori de observar uma classe yi, P(yi).
É necessário manter um contador para cada classe
É necessário discretizar os atributos contínuos
É necessário possuir n + 1 atributos repetidos
É necessário possuir n – 1 atributos repetidos
Analise o algoritmo abaixo, escrito em pseudocódigo (Portugol).
Algoritmo “Prova”
Var
__n, cont, acum: Inteiro
Início
__n ← 0
__acum ← 0
__Para cont de 1 até 5 faça
____n ← cont + 2
____acum ← acum + n
__ Fimpara
Fim
Ao final da execução do algoritmo acima, qual será o valor da variável “acum”?
12
14
18
20
25
Avalie o algoritmo abaixo, escrito no software VisuAlg 3.0.
algoritmo "prefeitura" var cont, v: inteiro inicio cont <- 5 v <- 10 repita v <- v - cont cont <- cont - 1 até (cont = 0) fimalgoritmo |
Ao final da execução do algoritmo acima, qual será o valor da variável “v”?
-10
-5
0
5
10
Analise o algoritmo abaixo, escrito no software VisuAlg 3.0:
algoritmo "cálculo"
var
inicial, final: inteiro
funcao calcula(temp: inteiro): inteiro
inicio
se temp = 0 entao
retorne 0
senao
retorne temp + calcula(temp - 1)
fimse
fimfuncao
inicio
inicial <- 5
final <- calcula(inicial)
fimalgoritmo
Ao final da execução do algoritmo acima, qual será o valor da variável “final”?
5
15
25
10
0
Uma das métricas mais comumente utilizadas para comparar resultados de algoritmos de clusterização é obtida por meio da fórmula (b-a)/ max(a,b), em que:
a é a distância média entre os pontos dentro de cada cluster (distância média intra-cluster) e
b é a distância média para o cluster mais próximo (distância média para os pontos do cluster mais próximo).
A métrica descrita recebe o nome de:
R2.
silhouette score.
F1-score.
ROC.



