







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
As empresas têm como opção a utilização de diversas tecnologias modernas, para facilitar o processo de tomada de decisão dos gestores, visando atender a sua complexidade, seu crescimento, sua modernidade, sua perenidade, sua rentabilidade e sua competitividade. Há uma tecnologia que é formada por um conjunto de ferramentas que, por meio do uso de algoritmos de aprendizado ou baseados em redes neurais e estatística, são capazes de explorar um grande conjunto de dados, extraindo destes na forma de hipóteses e de regras. Trata-se da seguinte tecnologia:
sistema gerenciador de banco de dados.
enterprise resource planning.
data warehouse.
sistemas especialistas.
data mining.
As ferramentas de Exploração identificadas como Ferramenta 1 e Ferramenta 2 na imagem, dentro do contexto a que se aplicam, são, dentre outras,
Staging Area e Data Mining.
OLAP e Data Mining.
Snowflake e Staging Area.
OLAP e Near Line Storage.
Near Line Storage e Star Schema.
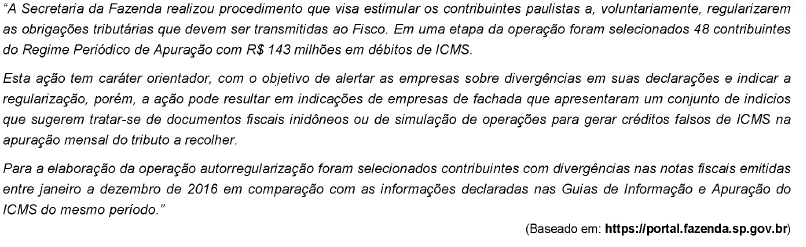
Ao ler esta notícia, uma Auditora Fiscal da área de TI concluiu, corretamente, que o cruzamento e a análise simultânea de diversas informações, como Nota Fiscal Eletrônica (NF-e), inadimplência, regularidade no cumprimento de obrigações, porte da empresa, composição do quadro societário, autos de infração anteriores, localização geográfica e atividade econômica, entre outras,
Em problemas de classificação no contexto da mineração de dados, é essencial que a performance de um modelo aplicado em um problema seja avaliada. Certas métricas e técnicas são bastante difundidas para esse fim. Sobre esse tema, analise as afirmativas a seguir:
I. A métrica de acurácia (accuracy) é mais efetiva do que as métricas de sensibilidade (sensitivity) e especificidade (specificity), pois não é afetada pelo problema de desbalanceamento de classes.
II. A métrica de F-score é dada pela combinação das métricas de sensibilidade (sensitivity) e precisão (precision) na equação: F = (2 × precision × sensitivity) / (precision + sensitivity).
III. A curva ROC (Receiver Operating Characteristic) é útil para medir a acurácia de um modelo, onde quanto mais próximo de 1 for sua área (AUC - area under the curve), pior é o modelo.
Assinale
se somente a afirmativa I estiver correta.
se somente a afirmativa II estiver correta.
se somente a afirmativa III estiver correta.
se somente as afirmativas I e II estiverem corretas.
se somente as afirmativas II e III estiverem corretas.
Considere que a SANASA busca realizar a gestão de recursos hídricos subterrâneos com base em parâmetros conhecidos que determinam a poluição das águas subterrâneas. Um desses parâmetros, para exemplificar, seria o nitrato, um indicador de poluição difusa de água subterrânea. Criando-se regras para realizar o aprendizado supervisionado do sistema de Data Mining utilizando-se uma certa técnica, chegar-se-á a um resultado que considera os diversos parâmetros para se descobrir se um certo aquífero tem água potável ou não, comparando-se com uma definição conhecida.
Nesse cenário, a técnica aplicada é denominada
Associação.
Classificação.
Clustering.
Regressão.
Prediction.
Sobre descoberta de conhecimento em bases de dados e mineração de dados, considere as seguintes afirmativas:
1. Uma forma de limpeza de dados é por meio do método de encaixotamento, que consiste em distribuir os valores de um atributo em um conjunto de caixas (bins).
2. O método de “imputação de dados” para suprir a ausência de valores acontece na etapa de transformação dos dados.
3. Capitalização e conversão de unidades são exemplos de padronização de dados na etapa de transformação dos dados.
4. O processo de normalização de dados ocorre na etapa de transformação de dados.
Assinale a alternativa correta.
Uma funcionalidade que pesquisa, agrega e organiza dados, de maneira que, através de análises encontre padrões, associações, mudanças, anomalias e outras informações relevantes, chama-se:
Data Mining.
Data Storage.
Data Scale.
Big Data.
Data Center.
Considerando os sistemas de gerenciamento de banco de dados, informações e conhecimento, associe o tema à sua ideia principal:
-
TEMA:
I Datamining.
II OLAP.
III Data Warehouse.
-
IDEIA PRINCIPAL:
-
a. utiliza recursos para a busca de informações relevantes que estão presentes em meio a grande quantidade de dados através de diversas técnicas, informações estas que muitas vezes ficam despercebidas.
b. oferece uma diversidade de recursos para que a informação possa ser analisada de diversos ângulos, oferecendo funcionalidades como consultas e relatórios dinâmicos que podem ser elaborados pelos próprios usuários.
c. é utilizado para armazenar conjuntos de dados organizados por assuntos, mantendo todo um histórico.
-
Está correto o que afirma em:
I-B, II-A e III-C.
I-A, II-B e III-C.
I-C, II-B e III-A.
I-A, II-C e III-B.
Acerca dos métodos tradicionais de Mineração de Dados, um desses métodos “produz Árvores de Decisão a partir de uma abordagem recursiva de particionamento de um conjunto de dados, e utiliza conceitos e medidas da Teoria da Informação”. Trata-se do método:
C4.5.
Apriori.
Máquinas de Vetores Suporte.
Classificador Bayesiano Ingênuo.
De acordo com Barbieri (2011), um conjunto de técnicas de natureza estatística é utilizado nos processos de Data Mining. Assinale a opção que apresenta esse conjunto de técnicas estatísticas.
Árvore de decisão, análise de conglomerados, análise de regressão e métodos preditivos com séries temporais.
Análise trigonométrica, produto cartesiano, fatorial e métodos preditivos com séries temporais.
Árvore de decisão, produto cartesiano, fatorial e análise de regressão.
Análise trigonométrica, árvore de decisão, análise de regressão e produto cartesiano.
Arvore de decisão, análise trigonométrica, análise de regressão e fatorial.
Considere o conjunto de dados a seguir, obtido a partir de uma base de dados de transações ocorridas em uma padaria, em uma determinada faixa de tempo. Nesse conjunto, indica-se a ocorrência de um determinado produto em cada transação.
id transação | leite | café | pão | manteiga |
1 | não | sim | sim | sim |
2 | sim | não | sim | sim |
3 | não | sim | sim | sim |
4 | sim | sim | sim | sim |
5 | não | não | não | não |
6 | não | não | não | sim |
7 | não | não | não | |
8 | não | não | não | não |
9 | não | não | não | não |
10 | não | não | não | não |
Em mineração de dados, a partir desse conjunto de dados, podem ser geradas regras de associação, as quais buscam conjuntos de itens frequentes que guardam entre si uma relação de causa e efeito. Essas regras são da forma X→Y, onde X é o antecedente da regra, e Y, seu consequente. A menção X,Y indica referência aos dois itens frequentes X e Y. Dois indicadores utilizados para averiguar a eficácia de regras de associação são o suporte e a confiança.
Qual das regras a seguir possui confiança mínima de 80%, dado um suporte mínimo de 30%?
café, leite → pão
café, pão → manteiga
leite, pão → café
manteiga → café, pão
manteiga, pão → café
São métodos de mineração de dados que podem ser aplicados à tarefa de Knowledge Discovery in Databases (KDD) de descoberta de associações, EXCETO:
DIC (Dynamic Itemset Counting).
Apriori.
Redes neurais artificiais.
DHP (Direct Hashing and Pruning).
As ferramentas e técnicas de mineração de dados (data mining) têm por objetivo
preparar dados para serem utilizados em um “data warehouse” (DW).
permitir a navegação multidimensional em um DW.
projetar, de forma eficiente, o registro de dados transacionais.
buscar a classificação e o agrupamento (clusterização) de dados, bem como identificar padrões.
otimizar o desempenho de um gerenciador de banco de dados.
A aplicação de técnicas de mineração de dados (data mining) pode ser de grande valia para o Auditor. No caso das pesagens, por exemplo, uma ação típica de mining, que é passível de ser tomada com o auxílio de instrumentos preditivos, é
quantificar as ocorrências de possíveis pesagens fraudulentas ocorridas durante todo o trimestre que antecede a data da análise, em alguns postos selecionados, mediante parâmetros comparativos preestabelecidos.
analisar o percentual de ocorrências das menores permanências de caminhões nos postos, no último ano, em relação ao movimento total.
relacionar os postos onde ocorreram, nos últimos seis meses, as menores permanências das empresas suspeitas e informar o escalão superior para a tomada de decisão.
realizar uma abordagem surpresa em determinado posto, com probabilidade significativa de constatar ocorrência fraudulenta.
reportar ao escalão superior as características gerais das pesagens e permanências de todos os caminhões, nos cinco maiores postos do Estado, no mês que antecede a data de análise.



