








Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
No âmbito do aprendizado de máquina não supervisionado, os algoritmos de agrupamento (clustering) apresentam diferentes abordagens para a organização de dados sem rótulos. Considerando as propriedades operacionais dos algoritmos k-means, DBSCAN e SOM (self-organizing maps), assinale a opção correta.
O DBSCAN e o SOM operam sob a mesma função de custo baseada na minimização da soma dos erros quadráticos (SSE) em relação a um ponto central fixo.
O k-means é um algoritmo de particionamento que minimiza a variância intracluster, sendo inerentemente robusto quanto à presença de outliers devido ao uso da média aritmética para o cálculo dos centroides.
O DBSCAN fundamenta-se na densidade local de pontos, permitindo a identificação de agrupamentos de formas geométricas arbitrárias e a segregação de ruído, prescindindo da especificação prévia do número de clusters.
O SOM utiliza uma arquitetura de rede neural competitiva para realizar a redução de dimensionalidade e o agrupamento, garantindo a preservação da topologia global sem a necessidade de definir uma vizinhança entre os neurônios.
O k-means apresenta desempenho superior ao DBSCAN na detecção de agrupamentos não convexos ou com densidades significativamente distintas.
Uma Fundação Pública foi incumbida de analisar dados socioeconômicos de municípios, considerando variáveis como renda per capita, índice de escolaridade e acesso a saneamento básico. O objetivo é identificar grupos de municípios com características semelhantes, sem a existência de categorias previamente definidas, permitindo a segmentação para políticas públicas mais específicas. Considerando os tipos de algoritmos de aprendizado de máquina, assinale a alternativa que apresenta um algoritmo adequado para realizar essa tarefa.
Regressão Logística.
DBSCAN (Density-Based Spatial Clustering of Applications with Noise).
Árvore de Decisão.
Naive Bayes.
Em uma secretaria de fazenda, analistas de dados buscam identificar perfis de contribuintes com padrões semelhantes de comportamento tributário, de modo a orientar auditorias fiscais preventivas. Nesse contexto, a escolha do método analítico deve considerar a ausência de rótulos previamente definidos e o grande volume de atributos numéricos e categóricos associados às declarações.
A partir da situação anterior, assinale a opção em que é corretamente descrita a técnica mais adequada para a finalidade pretendida pelos analistas de dados em questão.
A análise de correlação é a técnica mais apropriada para detectar grupos de contribuintes com comportamentos fiscais similares, pois avalia a dependência estatística entre múltiplas variáveis simultaneamente.
As árvores de decisão são técnicas não supervisionadas de agrupamento hierárquico, ideais para identificar automaticamente padrões ocultos entre variáveis fiscais heterogêneas.
A análise discriminante é adequada para o agrupamento de contribuintes sem rótulos prévios, pois utiliza métricas de distância para maximizar a separação entre grupos formados aleatoriamente.
A regressão logística, por ser um método supervisionado, permite agrupar contribuintes com base em características comuns, estimando probabilidades de pertencimento a grupos previamente não definidos.
O algoritmo k-means é apropriado para segmentar contribuintes em grupos com padrões semelhantes, desde que as variáveis categóricas sejam previamente transformadas em representações numéricas adequadas.
Uma Secretaria da Fazenda Estadual precisa analisar 500 mil declarações fiscais para identificar contribuintes com comportamento tributário similar, sem ter exemplos prévios de classificação. A equipe técnica deve agrupar as empresas considerando apenas as características declaradas (receita, despesas, setor, localização) e descobrir padrões naturais nos dados.
A técnica mais adequada para essa tarefa é:
Árvores de decisão, pois criam regras hierárquicas de classificação baseadas em variáveis fiscais usando exemplos rotulados de empresas regulares e irregulares.
Análise de séries temporais, pois identifica tendências e padrões sazonais na arrecadação tributária ao longo do tempo para projeções futuras de receita.
Regressão logística, pois classifica empresas em categorias de risco fiscal utilizando variáveis preditoras numéricas e categóricas com base em histórico de autuações anteriores.
K-means clustering, pois agrupa empresas por similaridade sem necessidade de rótulos prévios, identificando padrões naturais nos dados declarados pelos contribuintes.
Redes neurais profundas, pois aprendem representações complexas dos dados fiscais através de múltiplas camadas ocultas treinadas com backpropagation supervisionado.
Algoritmos não supervisionados identificam agrupamentos ou estruturas ocultas nos dados sem a necessidade de rótulos prévios, operando exclusivamente sobre as observações.
Certo
Errado
Uma equipe de análise de dados da Assembleia Legislativa recebeu a missão de identificar padrões de atuação parlamentar a partir de milhares de registros que continham informações sobre proposições apresentadas, votações realizadas, participação em comissões, temas recorrentes e indicadores de atividade legislativa. Como não existia uma classificação prévia dos parlamentares nem categorias definidas antecipadamente, optou-se pela utilização de técnicas de aprendizado não supervisionado para explorar possíveis agrupamentos naturais presentes na base de dados. Durante os testes, observou-se que alguns parlamentares possuíam comportamento muito distinto dos demais, formando pequenos grupos isolados em regiões de baixa densidade.
Assinale a alternativa que apresenta a técnica de agrupamento adequada para identificar agrupamentos de formatos arbitrários e, simultaneamente, reconhecer observações isoladas como potenciais ruídos.
O algoritmo K-means, por utilizar centroides iterativamente ajustados e particionar todos os registros em quantidade previamente definida de grupos.
O agrupamento hierárquico aglomerativo, por exigir a construção de uma árvore de similaridade que elimina a ocorrência de observações atípicas.
O algoritmo K-means, por permitir que registros distantes permaneçam sem associação a grupos durante o processo de convergência.
O agrupamento hierárquico divisivo, por classificar automaticamente observações dispersas como ruídos sem necessidade de critérios adicionais.
O algoritmo DBSCAN, por utilizar densidade de pontos para formar agrupamentos e identificar observações isoladas que não pertencem a regiões densamente conectadas.
Para processar terabytes de logs de notas fiscais eletrônicas, o TCE-SC utiliza um cluster Apache Spark. O Auditor nota que o processamento está lento devido ao excesso de movimentação de dados entre os nós da rede durante operações de agrupamento.
A operação do Spark conhecida por causar esse fenômeno de Shuffle e que deve ser utilizada com cautela em grandes datasets é:
map()
filter()
groupByKey()
broadcast()
first()
Janaina, uma analista da ALEGO, desenvolveu o programa Python (versão 3) que utiliza as bibliotecas numpy (2.0.2) e scikit-learn (versão 1.6.1) para realizar uma análise de agrupamentos. Analise o código a seguir.
from sklearn.cluster import KMeans
import numpy as np
X = np.array([[1, 2], [1, 4], [1, 0],
[10, 2], [10, 4], [10, 0]])
kmeans = KMeans(n_clusters=2, random_state=0, n_init="auto").fit(X)
kmeans.labels_
kmeans.predict([[1, 1], [14, 4]]) kmeans.cluster_centers_
O resultado impresso é igual a
array([[1., 2.],
[ 10., 2.]])
array([[1., 4.],
[ 10., 4.]])
array([[1., 3.],
[ 9., 4.]])
array([[10., 4.],
[ 1., 4.]])
array([[10., 2.],
[ 1., 2.]])
Mineração de dados compreende um conjunto de técnicas usadas para identificar padrões, correlações, tendências e outras informações valiosas em grandes volumes de dados. Técnicas (métodos) de mineração de dados envolvem diferentes tipos de algoritmos para realizar tarefas sobre os dados, tais como classificação, análise de regressão e agrupamento (clustering). Qual característica é associada a algoritmos relacionados à análise de regressão no contexto de mineração de dados?
Algoritmos de regressão estimam relações matemáticas contínuas entre variáveis, podendo modelar tendências e prever valores numéricos.
Algoritmos de regressão identificam semelhanças em instâncias de dados numéricos, criando classes similares e atribuindo rótulos aos dados.
Algoritmos de regressão analisam dados passados, identificando padrões numéricos e criando hipóteses para explicar a evolução dos dados.
Algoritmos de regressão transformam conjuntos de dados em pontos de um espaço de decisão, identificando correlações numéricas entre esses pontos.
O clustering (agrupamento) é uma técnica de aprendizado de máquina usada para agrupar objetos, dados e observações com base em semelhanças e padrões, sendo classificada como um tipo de aprendizado:
Por reforço.
Não supervisionado.
Supervisionado.
Semissupervisionado.
Uma equipe de inteligência legislativa recebeu a tarefa de identificar perfis de atuação parlamentar a partir de informações históricas relacionadas à apresentação de proposições, participação em comissões, frequência em sessões, temas de interesse e padrões de votação. Como não existiam categorias previamente definidas para os parlamentares analisados, optou-se pela utilização de técnicas de agrupamento para identificar estruturas naturalmente presentes nos dados. Durante os testes, foi necessário selecionar um método adequado para particionar os registros em grupos representados por centroides calculados iterativamente.
Assinale a alternativa que apresenta uma característica tecnicamente associada ao algoritmo K-means.
O algoritmo K-means identifica agrupamentos por densidade e classifica automaticamente observações isoladas como ruídos sem necessidade de parametrização prévia.
O algoritmo K-means constrói uma estrutura hierárquica de agrupamentos representada por dendrogramas, permitindo diferentes níveis de particionamento dos dados.
O algoritmo K-means determina automaticamente a quantidade ideal de agrupamentos por meio de procedimentos estatísticos incorporados ao próprio algoritmo.
O algoritmo K-means foi desenvolvido exclusivamente para variáveis categóricas, não sendo apropriado para análise de atributos numéricos contínuos.
O algoritmo K-means realiza particionamento dos dados em um número previamente definido de grupos, buscando minimizar a distância entre observações e centroides.
Um cientista de dados está desenvolvendo um modelo de segmentação para classificar procedimentos com base em características quantitativas.
Para garantir a comparabilidade entre variáveis, ele aplicou a padronização por escore z (z-score) em um conjunto de dados multivariados, de modo que todas as variáveis passassem a apresentar média 0 e desvio-padrão 1.
Após a padronização, verificou-se que os dados não apresentavam forte separação entre grupos naturais. Em seguida, foi aplicado o algoritmo K-means em Python:
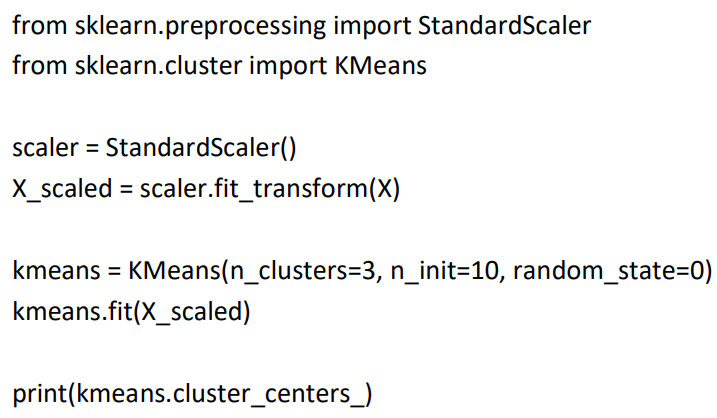
Observou-se que os centroides obtidos apresentam valores próximos de zero em todas as dimensões.
Considerando o contexto descrito, esse resultado ocorre porque
o K-means centraliza automaticamente os dados na origem durante a inicialização.
os centroides representam as médias dos grupos e, como os dados estão padronizados e não apresentam forte separação, essas médias tendem a permanecer próximas da média global zero.
o parâmetro random_state=0 força os centroides a convergirem para a origem.
a padronização elimina a variabilidade entre observações, tornando os centroides coincidentes.
o número de clusters determina que a soma vetorial dos centroides seja nula.
O k-means é um algoritmo iterativo de agrupamento baseado em centroides, isto é, ele divide um conjunto de dados em grupos semelhantes com base na distância entre seus centroides.
Certo
Errado
O algoritmo K-means garante a otimização dos clusters, independentemente da inicialização dos centroides, desde que a métrica de distância utilizada seja euclidiana, e os dados estejam em um espaço vetorial de baixa dimensionalidade.
Certo
Errado
A estagiária Mirella sabe que scikitlearn versão 1.6.1 oferece diversos algoritmos de aprendizado não supervisionado. No entanto, ela desconhece quais são os métodos de clusterização disponíveis no módulo sklearn.cluster.
Assinale a opção que contém apenas os nomes dos métodos de clusterização disponíveis no módulo.
Hdbscan e regressão logística.
Mean-shift e naive bayes.
Perceptron e optics.
Birch e k-means.
Dbscan e lasso.
O algoritmo de agrupamento K-means — baseado em centroides, que divide um conjunto de dados em grupos semelhantes com base na distância entre seus centroides — pode ser utilizado para, a partir de uma base de dados de uma rede social, identificar comunidades de usuários com interesses comuns em determinados assuntos.
Certo
Errado
O Aprendizado de Máquina (Machine Learning - ML) é uma subárea da Inteligência Artificial (IA) que capacita os sistemas a “aprenderem” a partir de dados, ou seja, a ajustarem seu comportamento com base em padrões identificados nos dados, sem a necessidade de programação explicita para cada tarefa. Em vez de serem programados para realizar tarefas específicas, os algoritmos de aprendizado de máquina analisam dados, detectam padrões e fazem previsões ou tomam decisões baseadas nesse aprendizado. Considerando isso, assinale a alternativa que apresenta a técnica de aprendizado de máquina que agrupa dados de maneira que os itens dentro de um grupo sejam mais semelhantes entre si e diferentes de outros grupos. Exemplo: segmentação de clientes com base em seu comportamento.
Redução de dimensionalidade.
Classificação.
Regressão.
Associação.
Clusterização.
Sobre algoritmos de mineração de dados, avalie as afirmativas a seguir e assinale (V) para a verdadeira e (F) para a falsa.
( ) K-means, também conhecido como K-NN, é um algoritmo baseado na ideia de que objetos semelhantes estão próximos uns dos outros.
( ) Árvore de decisão é uma estrutura hierárquica constituída por nós. Nela, o coeficiente de Gini de um nó é sempre maior do que o do seu nó pai.
( ) O algoritmo SVM, utilizado apenas para a tarefa de classificação, emprega classificadores lineares que separam o conjunto de dados por meio de hiperplanos, não sendo possível seu uso com problemas não linearmente separáveis.
As afirmativas são, respectivamente,
V – V – F.
F – V – V.
F – F – V.
V – F – F.
F – F – F.
Nos algoritmos aglomerativos, ocorre primeiramente a classificação de cada objeto em um grupo e, então, combinam-se os grupos com base em suas proximidades, processo repetido até que exista um cluster, que inclua todos os objetos; já nos algoritmos divisivos, todos os pontos são inicialmente considerados como grupo único, subdividido sucessivamente até que alguma regra de parada seja satisfeita.
Certo
Errado
Assinale a opção em que é corretamente apresentada uma limitação do particionamento final produzido pelo algoritmo k-means.
inaplicabilidade para grupos com formato aproximadamente esférico e de tamanhos variados
exigência de que os dados de entrada estejam previamente rotulados
imutabilidade do resultado final, independentemente da inicialização dos centroides
não utilização de medidas de distância, como a euclidiana, para o cálculo da similaridade entre pontos e centroides
necessidade de que o número de grupos (k) seja definido antes da execução do algoritmo



