Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Na inferência Bayesiana, muitas vezes o objetivo é utilizar as distribuições a posteriori, visando a obtenção de estimadores pontuais para um ou mais parâmetros de interesse. Associada com cada estimador, existe uma função perda, que é interpretada como a perda sofrida ao estimar o parâmetro desconhecido por um estimador específico. A função de perda atrelada à moda a posteriori denomina-se:
0-1
Jeffreys.
Absoluta.
Imprópria.
Quadrática.
A estimativa pontual do parâmetro pode ser inferior a 5.
Certo
Errado
Ao fazer o ajuste do modelo de regressão, foi obtida a seguinte reta apresentada na figura abaixo:
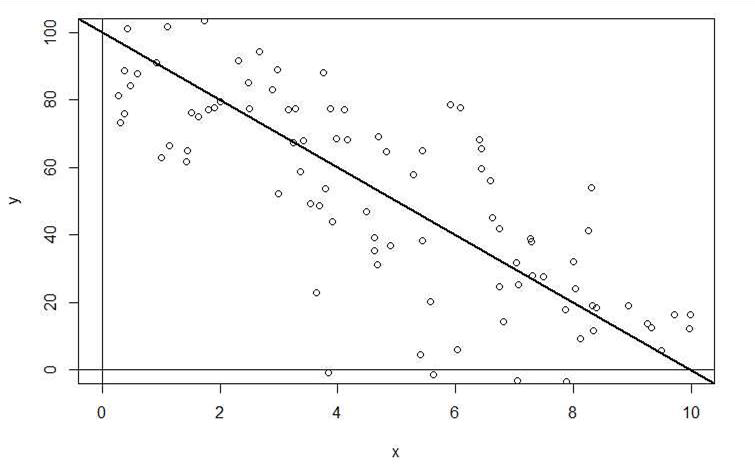
De acordo com a figura, os valores estimados do Intercepto (alpha) e coeficiente angular (beta) são dados respectivamente por
100 e 10.
10 e -10.
100 e 0.
100 e -10.
10 e 10.
Uma pesquisa foi realizada para analisar a relação entre a quantidade de horas de estudo semanal (variável independente) e o desempenho acadêmico (variável dependente) dos estudantes de uma universidade. Um modelo de regressão linear simples foi ajustado para uma amostra de tamanho 500, e os seguintes resultados foram obtidos:
I - Coeficiente estimado para a variável horas de estudo (x): 0.75.
II - Erro padrão do coeficiente estimado para a variável horas de estudo: 0.05.
Com base nessas informações, selecione a alternativa correta com relação ao coeficiente estimado para a variável de estudo.
Ele não é estatisticamente significativo a nível de 95%, pois o valor t calculado é menor que o valor crítico t.
Ele não é estatisticamente significativo a nível de 95%, pois o valor t calculado é maior que o valor crítico t.
Ele é estatisticamente significativo a nível de 95%, pois o valor t calculado é menor que o valor crítico t.
Ele é estatisticamente significativo a nível de 95%, pois o valor t calculado é maior que o valor crítico t.
Não é possível determinar a sua significância estatística com base nas informações fornecidas.
É correto afirmar que
o comando da linha 6 calcula o somatório dos valores de Y, X1 e X2, gerando um vetor com esses três valores.
o comando da linha 9 gera um único gráfico de dispersão em 3 dimensões representando os pontos (Y, X1, X2).
o comando da linha 4 realiza o cálculo matricial Y(X1)T(X2), onde (X1)T é a transposta de X1.
os comandos das linhas 10 a 12 calculam, baseado no modelo de regressão linear denominado “modelo”, uma previsão para o valor de Y com os valores X1 = 13 e X2 = 4.
o comando da linha 7 obtém o valor do coeficiente de determinação (R2) do modelo de regressão linear ajustado.
No processo de estimação de parâmetros associados à distribuição de uma variável aleatória X, através de intervalos de confiança baseados no método da quantidade pivotal, pode-se afirmar que
o intervalo (–15,5 ; –5,5) com 95% de confiança, para a média de uma distribuição Normal tem erro de estimação igual a 10.
quando se aumenta o tamanho da amostra, diminui-se o erro padrão do estimador e, consequentemente, diminui-se a amplitude do intervalo de confiança.
o intervalo (8,6 ; 16,8), com 95% de confiança, para a variância de uma distribuição Normal tem erro de estimação igual a 4,1.
a quantidade pivotal usada na construção do intervalo para a variância de uma distribuição Normal tem distribuição t-Student.
a quantidade pivotal usada na construção do intervalo para a variância de uma distribuição Normal tem distribuição Normal.
Se μ denota a média populacional desconhecida, então seu espaço paramétrico é representado pelo conjunto {51, 21} .
Certo
Errado
O valor 4 representa uma estimativa do produto n × p.
Certo
Errado
Mediante técnicas matemáticas diferenciadas, os métodos de estimação, para estimadores da classe BLUE, visam obter uma estimação não viesada.
A estimativa de um parâmetro é intrinsecamente enviesada.
Entre dois estimadores, A e B, com consistência, viés e demais características iguais, o estimador mais útil é aquele que possui menor variância.
A soma X1 + X2 +... + X10 é uma estatística suficiente para a estimação do parâmetro μ.
Certo
Errado
Em modelos de regressão linear existem três métodos de estimação mais frequentemente empregados. São eles o de Mínimos Quadrados Ordinários (MQO), o do Melhor Estimador Linear Não Tendencioso (BLUE) e o de Máxima Verossimilhança (MV).
Sobre esses métodos, supondo válidos os pressupostos básicos do modelo, é correto afirmar que:
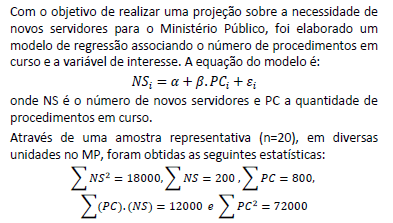
Com base no modelo e nas estatísticas, é correto afirmar que:
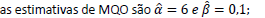
 positiva, o número de funcionários do MP deverá crescer a uma taxa de 10% ao período.
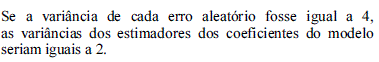
Em uma regressão linear as propriedades dos estimadores de MQO estão relacionadas com a validade dos pressupostos sobre os erros aleatórios.
Sobre essa correspondência entre propriedades e pressupostos, é correto afirmar que:
As técnicas administrativas, associadas a programas adequados de computação, constituem valiosos instrumentos na administração. Vejamos um exemplo de aplicação da estatística à administração.
“Os Conselhos Regionais de Biblioteconomia de Fortaleza, de Recife, de Salvador e de São Luís querem promover um grande evento para falar dos projetos para 2016 e, para tanto, querem a opinião/sugestão dos seus funcionários. Para isso, podem fazer uma pesquisa entrevistando um número X de funcionários de cada departamento de cada Conselho, que tenham entre 26 e 45 anos. Assim, poderão usar os resultados para estimar as sugestões mais relevantes de todo o quadro de funcionários das entidades.” Sobre os conceitos relacionados à estatística, leia as afirmativas seguintes.
I. A principal razão para o uso de amostras é que seria por demais dispendioso pesquisar toda a população.
II. A inferência estatística tem como objetivo estudar generalizações sobre uma população por meio de evidências fornecidas por uma amostra retirada desta população.
III. Não há maneira de saber, com certeza, se a amostra representa perfeitamente a população, a menos que se faça um censo sobre toda a população.
Pode-se afirmar que:
somente I e II estão corretas.
somente I e III estão corretas.
somente II e III estão corretas.
há somente uma afirmativa correta.
todas estão corretas.
Seja o conjunto de pares de valores (X, Y):
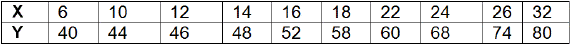
ajustando-se aos dados o modelo Y = β0 + β1X + ε, onde Y é a variável resposta, X é a variável explicativa, β0 e β1 são os parâmetros e ε é o erro, se obtém as seguintes estimativas dos parâmetros:
10,80 e 0,95.
25,15 e 2,01.
11,12 e 1,05.
26,12 e 2,35.
27,13 e 1,66.
Suponha que um advogado pretenda estimar o valor concedido para processos de danos morais com relação à idade do proponente. Para isso, ele observou que a relação entre essas variáveis é descrita por Y = - 3.500 + 100 . X. Suponha, ainda, que com o objetivo de simplificar a interpretação do modelo, o advogado decida considerar uma nova variável, Z = X - 35, como regressora, criando um modelo com intercepto igual a zero. Nessa situação, é correto afirmar que a variância dos estimadores permanece inalterada.