





Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Considere que um estudo foi realizado com o objetivo de avaliar se a variável dependente (Y) está relacionada linearmente com a variável independente (X).Apartir dos dados de uma amostra de 10 pares de medidas (xi, yi) com i = 1, 2, ..., 10, foi obtido o coeficiente de correlação de Pearson r = 0,9.
Levando em consideração o texto anterior e sabendo que V = 3X + 5 e W = cY + d, onde c e d são números reais positivos, analise as afirmativas a seguir.
I. O modelo de regressão ajustado Y = a.bX explica aproximadamente 90% da variação total em Y.
II. O coeficiente de correlação de Pearson entre X e V é 1.
III. O coeficiente de correlação de Pearson entre X e W é 0,9c + d.
IV. O coeficiente de correlação de Pearson entre V e W é 0,9.
Está(ão) correta(s) a(s) afirmativa(s)
II, apenas.
II e IV, apenas.
I e III, apenas.
I, III e IV, apenas.
Em uma regressão foi obtida a seguinte tabela ANOVA:
Fonte de Variação | Graus de Liberdade (GL) | Soma dos Quadrados (SQ) | Quadrados Médios (QM) | F |
Regressão | 1 | 960 | 960 | 30,24 |
Resíduo | 20 | 635 | 31,75 | |
Total | 21 | 1.595 |
Assinale a opção que indica quantos por cento a variação explicada pela regressão representa da variação total.
39,81%
60,19%
66,15%
77,58%
96,80%
Considere uma amostra aleatória de oito motoristas segurados por uma empresa e com apólices de seguro de automóveis semelhantes. Na figura evidenciada, a reta representa o ajuste de um modelo de regressão linear simples com Y = valor mensal do seguro e X = anos de experiência de direção, juntamente com os respectivos gráficos boxplot das variáveis:
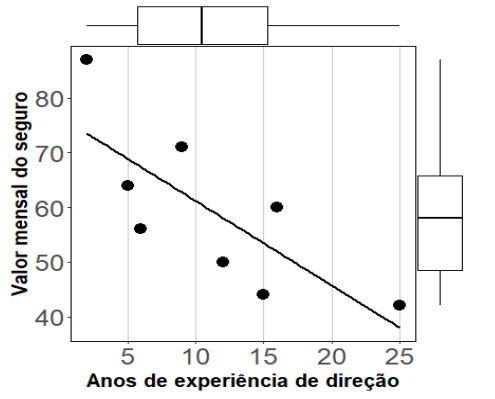
Levando em consideração estes dados, assinale a alternativa INCORRETA.

Na reta de regressão ajustada, y = a + bx , tem-se que a > 0 e b < 0.
A distância interquartílica dos dados da variável X é, aproximadamente, 5.
Considerando r o coeficiente de correlação linear de Pearson amostral, sabe-se que r < 0.
Se os coeficientes de variação das variáveis X e Y são, respectivamente, 65% e 25%, então os dados da variável Y são mais homogêneos que os dados da variável X.
Em se tratando de regressão linear, assinale a opção que apresenta uma afirmativa INCORRETA.
A correlação mede a força, ou grau, de relacionamento entre duas variáveis.
A regressão linear simples constitui uma tentativa de estabelecer uma equação matemática linear que descreva o relacionamento entre duas variáveis.
Uma das hipóteses da análise de regressão é a de que a variável dependente é aleatória.
O coeficiente de correlação está relacionado ao grau em que as predições baseadas na equação de regressão superam as predições baseadas na média.
Na regressão, quando os valores de Y são preditos com base nos valores de X, diz-se que Y é a variável dependente.
A metrologia abrange todos os aspectos teóricos e práticos relativos às medições, qualquer que seja a incerteza em qualquer campo da ciência ou da tecnologia. Analisando a estatística como instrumento de uso da metrologia, é INCORRETO afirmar que:
O resultado da medição é composto de duas parcelas: o resultado-base e a incerteza de medição.
A exatidão é a capacidade de um sistema funcionar sem erros, tendo sempre um desempenho ótimo.
O erro grosseiro geralmente é decorrente do mau uso ou do mau funcionamento do sistema de medição.
O erro aleatório é a parcela previsível que faz com que medições repetidas levem a distintas indicações.
A precisão representa a capacidade de obter sempre o mesmo resultado quando repetições são efetuadas.
Considerando os indicadores utilizados na análise de regressão, marque a única opção correta dentre as afirmações abaixo.
A mediana e a moda são a base da análise de regressão
O R quadrado é a razão entre a variação explicada e a variação total da dispersão dos dados em relação à reta de regressão no modelo linear
A análise de regressão requer o teste qui-quadrado para validação
O erro-padrão é utilizado na análise de regressão para a determinação do intervalo de confiança ao redor de cada ponto da reta de regressão
A estatística F para os coeficientes da variável independente, é o valor da prova e tem por objetivo testar se o efeito da variável independente sobre a dependente é ou não estatisticamente significativo
Um economista decide fazer uma regressão linear para estudar o preço do dólar baseado em dados reais. Ele pretende prever o preço do dólar em janeiro de 2020 baseado nos dados de anos anteriores no mesmo mês. Ele olha a tabela abaixo:
Mês | Janeiro de 2016 | Janeiro de 2017 | Janeiro de 2018 | Janeiro de 2019 |
Valor em R$ | 4,05 | 3,19 | 3,87 | 3,65 |
Sendo assim, após a realização de sua regressão linear, e sabendo que o preço correto em janeiro de 2020 foi de R$ 4,02, então, ele encontrou o valor de:
R$ 0,12 abaixo do preço real.
R$ 0,26 abaixo do preço real.
R$ 0,40 acima do preço real.
R$ 0,46 abaixo do preço real.
R$ 1,05 acima do preço real.
Assinale a opção que completa corretamente as lacunas da sentença abaixo.
Na regressão, os valores de y são preditos com base em valores dados ou conhecidos de x. A variável y é chamada de ________ e a variável x é chamada de ___________.
aleatória / dependente
dependente / independente
independente/ dependente
dependente/ aleatória
aleatória/ sistemática
Assinale a alternativa INCORRETA:
O coeficiente de determinação é uma medida de ajustamento de um modelo estatístico linear generalizado, como a regressão linear, em relação aos valores observados.
A análise de correlação fornece um número que resume o grau de relacionamento linear entre as duas variáveis. Já a análise de regressão fornece uma equação que descreve o comportamento de uma das variáveis em função do comportamento da outra variável.
A diferença entre a regressão linear simples e a múltipla é que na múltipla é ratada apenas uma variável explicativa.
A análise de regressão consiste na realização de uma análise estatística com o objetivo de verificar a existência de uma relação funcional entre uma variável dependente com uma ou mais variáveis independentes.
Suponha que um econometrista está avaliando o conjunto de variáveis explicativas que deve ser incluído em um modelo de regressão, podendo usar os métodos de Backward ou Forward ou Stepwise.
Sobre essas alternativas, é correto afirmar que:
o método de Backward seleciona inclusões a partir do menor nível de significância de uma distribuição Qui-quadrado;
o método de Forward seleciona inclusões a partir do maior nível de significância num teste de razão de verossimilhança;
no método de Stepwise, aplicado a curva Logit, as inclusões se dão através do menor p-valor associado a uma F-Snedecor;
o método de Forward seleciona exclusões a partir do menor nível de significância de uma estatística F-Snedecor observada;
no método de Backward as exclusões seguem dois critérios, um relativo de comparação entre estatísticas F observadas e outro absoluto, através de um nível de significância fixado.
Com relação ao conceito de Análise de Regressão, analise as afirmativas abaixo:
1. A análise de regressão tem por objetivo descrever, através de um modelo matemático, a relação existente entre duas variáveis, a partir de n observações dessas variáveis.
2. O modelo probabilístico, empregado na análise de regressão, é composto por três partes, uma que diz respeito às variáveis, outra aos parâmetros, e outra ao erro de estimativa.
3. A finalidade de uma equação de regressão seria estimar valores de uma variável, com base em valores conhecidos da outra.
Assinale a alternativa que indica todas as afirmativas corretas.
É correta apenas a afirmativa 2.
São corretas apenas as afirmativas 1 e 2.
São corretas apenas as afirmativas 1 e 3.
São corretas apenas as afirmativas 2 e 3.
São corretas as afirmativas 1, 2 e 3.
Acerca do modelo de regressão linear múltiplo clássico, analise as afirmativas.
I- Se a hipótese de homocedasticidade for violada, os estimadores de Modelo de Mínimos Quadrados Ordinários (MQO) serão viesados.
II- Assumindo que todos os pressupostos clássicos sejam satisfeitos, então os estimadores de MQO serão os melhores estimadores na classe dos lineares.
III- Se o valor esperado dos erros estimados do modelo for diferente de zero, então os estimadores de todos os parâmetros, inclusive o intercepto, não serão de mínima variância.
Está correto o que se afirma em
I e III, apenas.
II, apenas.
II e III, apenas.
I, II e III.
Uma regressão irá relacionar o logaritmo dos salários (y), com a experiência (x). Supõe-se que os ganhos com a experiência são positivos, mas decrescentes (os salários aumentam significativamente quando a experiência aumenta de 0 para 5 anos, mas nem tanto quando aumenta de 20 para 25 anos). O modelo utilizado será
y = α + βx + γx2
de modo que se espera que
β seja positivo e γ negativo.
β seja positivo e γ positivo.
β seja negativo e γ negativo.
β seja negativo e γ positivo.
β seja positivo e γ igual a zero.
Na estimação do vetor de parâmetros , em modelos lineares, podem ser utilizados vários métodos. Os mais comuns são o Método dos Mínimos Quadrados e o Método da Máxima Verossimilhança. O propósito desses métodos é encontrar um estimador para o vetor de parâmetros tal que o somatório dos quadrados das distâncias entre cada ponto observado e seu correspondente estimado pelo modelo seja mínimo. Para esses dois métodos citados, os estimadores obtidos são iguais, no entanto, pode ocorrer, que para métodos diferentes, resultam-se estimadores diferentes. Nesses casos, é necessário escolher o melhor estimador. Assinale a alternativa que apresenta o(s) principal(is) critério(s) utilizado(s) para avaliar um estimador de um parâmetro para um modelo linear.
Considere o seguinte:
1. Não viesado - E(
) = βi ;
2. Consistência -
(|
− βi| ≥ ε)= 0 para qualquer ε > 0;
3. Suficiência - quando a função de densidade de probabilidade conjunta condicional das
observações amostrais, dado
, não depende do parâmetro
;
4. Variância Mínima - um estimador
é de variância mínima de
se para qualquer outro
estimador
* var(
) ≤ var(
*) para todo
*.
5. Normalidade – os parâmetros
devem distribuir-se conforme a distribuição normal padrão.
Não viesado.
Não viesado, Consistência, Suficiência e Variância Mínima.
Não viesado, Suficiência, Variância Mínima e normalidade.
Não viesado, Variância Mínima e normalidade.
Viesado, Consistência, Suficiência.
O tamanho da amostra utilizada para o ajuste do referido modelo de regressão foi igual a 25.
Uma quantidade que permite determinar pontos influentes para um modelo de regressão ajustado é:
Distância de Cook.
Resíduo studentizado.
Resíduo studentizado externamente.
Resíduo ordinário.
Suponha que o Governo Federal tenha desenvolvido um modelo econométrico para avaliar os cursos de graduação ofertados no país. O modelo de regressão múltipla foi estimado pelo método de mínimos quadrados ordinários (MQO) e apresentou os seguintes resultados para o Fator de Tolerância (1/VIF) e Fator Inflacionário da Variância (VIF):
Variable | VIF | 1/VIF |
pobres educacao theil | 14.88 7.41 4.64 | 0.067190 0.134940 0.215448 |
Mean VIF | 8.98 |
Pelos valores apresentados para o (1/VIF) e (VIF), é correto afirmar que o modelo apresenta
multicolinearidade.
heterocedasticidade.
autocorrelação.
autocorrelação espacial.
homocedasticidade.
Os valores substituídos pelas letras A, B e C na tabela são, respectivamente:
Considere o modelo de regressão linear de séries temporais a seguir.
Ct=β0+β1Yt+ut
Sendo Ct o consumo pessoa, Yt a renda pessoal, e ut o termo aleatório, onde o subscrito t indica o tempo e t=1,...,T, assinale a alternativa correta.
Se as séries Ct e Yt são cointegradas e não estacionárias, então deve-se realizar a regressão de suas primeiras diferenças, ou seja, ∆Ct e ∆Yt.
Se as séries Ct e Yt são integradas de primeira ordem, mas o termo ut for não integrado (integração de ordem zero), então não há cointegração entre as variáveis.
Se as séries Ct e Yt são integradas de primeira ordem, então o termo ut é necessariamente estacionário.
Se as séries Ct e Yt são integradas de primeira ordem, então são necessariamente cointegradas.
Se as sériesCt e Yt tiverem diferentes ordens de integração, podem ser cointegradas.
A UFPA resolveu adotar critérios estatísticos para a Matriz de Distribuição de Vagas Docentes, para estabelecer um índice de necessidade (IN), determinando assim o número de professores que uma faculdade deverá ter em regime de 40 horas ou dedicação exclusiva. Foram considerados fatores (mensurados em horas) como: (i) Ensino e orientação de Graduação (Gr), Ensino e Orientação de Pós-Graduação (PG), (iii) Projeto de Pesquisa (PP), (iv) Projeto de Extensão (Ext), Projeto de Ensino (Ens), Administração (Adm) e Licenças (Lic). Através de um modelo de regressão foram obtidas as seguintes estimativas, com Coeficiente de Explicação de 86,64%:
Com base nos resultados, é correto afirmar que

foi adotado o modelo: Docentes = b1Grad + b2PG + b3PP + b4Ens + b5Ext + b6Adm + b7Lic.
para cada 47 horas adicionais na Pós-Graduação necessita-se de um docente a mais.
a variável Projeto de Ensino foi a mais importante no modelo.
o Coeficiente de Correlação foi 0,8664.
a Soma de Quadrados dos Resíduos foi de 13,36%.

