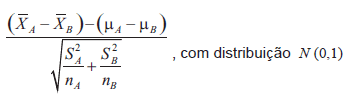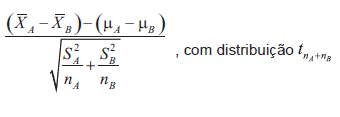Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Uma pesquisa por amostragem domiciliar foi realizada em uma localidade que possui 30 domicílios. A amostra de 5 domicílios foi obtida de acordo com os seguintes passos:
Passo 1 - organização dos 30 domicílios em uma lista, numerando-os de 1 a 30.
Passo 2 - seleção aleatória de um domicílio, dentre aqueles numerados de 1 a 6 (o domicílio selecionado no passo 2 foi o de número 4).
Passo 3 - inclui-se na amostra os seguintes domicílios (além do 4, selecionado no passo 2): 10, 16, 22 e 28 (ou seja, a partir do domicílio 4, seleciona-se de 6 em 6 domicílios).
A amostragem adotada foi
aleatória simples
estratificada simples
sistemática simples
de conglomerados
em dois estágios
A disponibilidade do cadastro permite que o analista efetue uma seleção por amostragem aleatória simples ou por amostragem sistemática com base nos códigos de identificação dos pacotes.
Analise as assertivas e assinale a alternativa que apresenta a(s) correta(s). Pretende-se implantar um sistema de transporte público na cidade. O ITM/Rede, indicador de quantidade de terminais/pontos em uma dada rede, fornece o número de pontos de ônibus que serão necessários para o deslocamento populacional do trecho específico. Quais são os itens que compõe este indicador?
I. Total de passageiros transportados no mês (em dias úteis) e total de dias úteis no mês.
II. Distância média pretendida entre terminais/pontos e extensão total da rede, ambos em metros.
III. Indicador de consumo médio diário de combustível e distância percorrida (em quilômetros).
IV. Tamanho da população e erro amostral tolerável.
Se o analista desejar fazer uma amostragem intencional (não probabilística) de tamanho n = 10, com base em sua experiência pessoal, então, nesse caso, a variância do estimador de uma proporção p será igual a u(1 - u)/500, em que u é uma probabilidade a priori estabelecida subjetivamente pelo analista.
Uma pesquisa de âmbito nacional para obter a intenção dos brasileiros na eleição para presidente da República pode ser feita com base em uma amostragem que considera pelo menos três estágios: por região, por estado e por município.
No plano de amostragem por cotas, uma técnica probabilística, divide-se a população em classes de interesse e se seleciona uma quantidade de indivíduos de cada classe (quotas) para compor a amostra.
Se o analista optar pela amostragem sistemática, a seleção de uma amostra de tamanho n = 50 será efetuada de 10 em 10 pacotes, e o primeiro pacote a ser inspecionado será, necessariamente, o primeiro pacote registrado no cadastro.
O método de reamostragem bootstrap é paramétrico se uma distribuição de probabilidade teórica for especificada; e é não paramétrico se for considerada uma distribuição empírica dos dados em estudo.
Na estimação de uma proporção p por amostragem aleatória simples, a variância do estimador é máxima quando p = 0,5.
Na amostragem aleatória simples, a ordem dos elementos na amostra não é relevante: as amostras {X, Y, Z} e {Z, X, Y}, por exemplo, são consideradas idênticas.
Com relação aos tipos de amostragem, podemos afirmar que:
O censo, por ouvir toda a população, sempre será a técnica de amostragem mais adequada em qualquer situação;
A amostragem aleatória simples com reposição fornece resultados mais precisos, com menor margem de erro do que a amostragem aleatória simples sem reposição;
A amostragem estratificada sempre fornece um resultado mais preciso, menor margem de erro, em comparação a qualquer amostragem aleatória simples;
Quanto maior o tamanho da população, menor é a margem de erro da amostragem aleatória simples com reposição;
A amostragem por conglomerados é um caso particular da amostragem estratificada.
O Teorema Central do Limite afirma que quando o tamanho de uma amostra aumenta, a distribuição das médias amostrais converge para uma distribuição:
qui-quadrado.
F de Fisher-Snedecor.
normal.
t de Student.
ognormal.
Considere que o lote de pacotes seja dividido em dois estratos segundo a massa de cada pacote: o primeiro, formado por 400 pacotes que possuem massas inferiores a 1 kg, e o segundo, por 100 pacotes com massas superiores a 1 kg. Nessa situação, se o analista efetuar uma amostragem estratificada de tamanho n = 50 com alocação uniforme, então essa amostra deverá contemplar 40 pacotes do primeiro estrato e 10 pacotes do segundo.
Para se calcular o tamanho da amostra com o objetivo de se estimar a proporção de pacotes que necessitam de recolhimento de impostos, independentemente do nível de confiança desejado, o analista deverá usar a fórmula n = 1/E2, em que E é o erro amostral.
No plano amostral por conglomerados, o coeficiente de correlação intraclasse mede o quanto os elementos dentro dos conglomerados são similares, sendo que, quanto maior for o coeficiente, mais heterogêneos são os conglomerados e melhores serão os resultados obtidos por meio desse tipo de plano amostral.
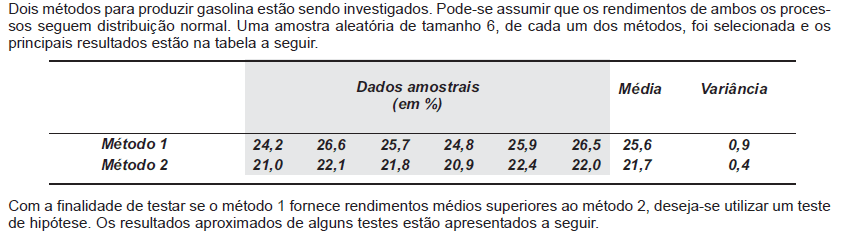
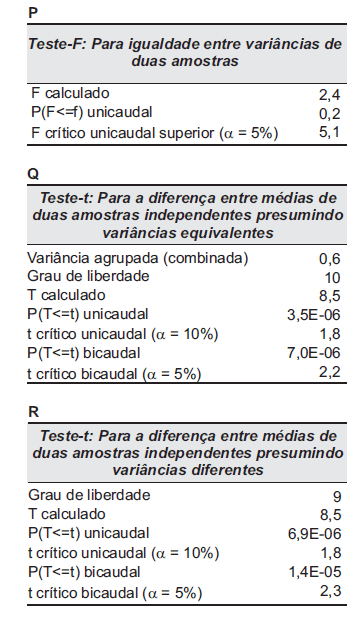
Com os resultados à esquerda e considerando o nível de significância de 10%, conclui-se que a hipótese de igualdade das variâncias (A) não é rejeitada
não é rejeitada segundo o teste P e, consequentemente, o teste utilizado para testar a hipótese do rendimento do método 1 ser superior ao do método 2 é o teste Q, que não rejeita a hipótese nula.
não é rejeitada segundo o teste P e, consequentemente, o teste utilizado para testar a hipótese do rendimento do método 1 ser superior ao do método 2 é o teste Q, que rejeita a hipótese nula.
não é rejeitada segundo o teste P e, consequentemente, o teste utilizado para testar a hipótese do rendimento do método 1 ser superior ao do método 2 é o teste Q, que rejeita a hipótese nula.
é rejeitada segundo o teste P e, consequentemente, o teste utilizado para testar a hipótese do rendimento do método 1 ser superior ao do método 2 é o teste Q, que rejeita a hipótese nula.
é rejeitada segundo o teste P e, consequentemente, o teste utilizado para testar a hipótese do rendimento do método 1 ser superior ao do método 2, é o teste R, que rejeita a hipótese nula.
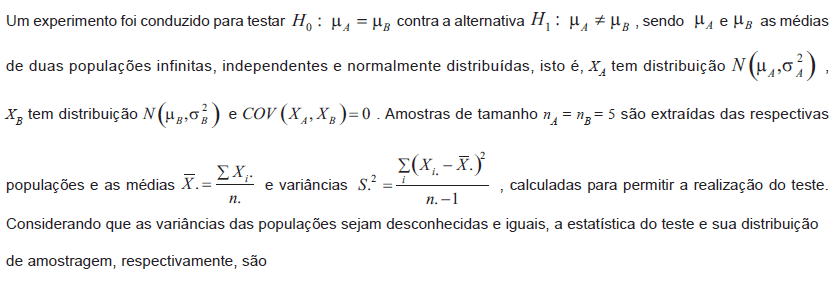
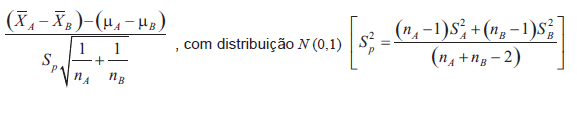
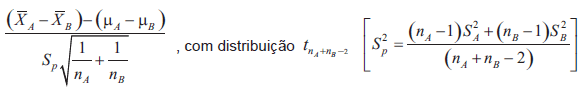
Um experimento foi conduzido para testar H0 : μA = μB contra a alternativa H1 : μA ≠ μB , sendo μA e μB as médias de duas populações infinitas, independentes e normalmente distribuídas, isto é, XA tem distribuição N(μA,σA2) , XB tem distribuição N(μB,σB2) e COV (XA, XB)=0 . Amostras de tamanho nA = nB = 5 são extraídas das respectivas populações e as médias X.=n.ΣXi. e variâncias S.2=n.−1∑i(Xi.−X.)2 , calculadas para permitir a realização do teste.
Considerando que as variâncias das populações sejam desconhecidas e iguais, a estatística do teste e sua distribuição de amostragem, respectivamente, são
SpnA1+nB1(XA−XB)−(μA−μB) , com distribuição N (0,1) [Sp2=(nA+nB−2)(nA−1)Sa2+(nB−1)Sb2]
nASa2+nBSB2(XA−XB)−(μA−μB) , com distribuição N (0,1)
SpnA1+nB1(XA−XB)−(μA−μB) , com distribuição tnA+nB−2[Sp2=(nA+nB−2)(nA−1)Sa2+(nB−1)Sb2]
nASa2+nBSB2(XA−XB)−(μA−μB) , com distribuição tnA+nB
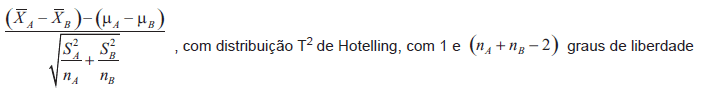
nASa2+nBSB2(XA−XB)−(μA−μB) , com distribuição T2 de Hotelling, com 1 e (nA+nB−2) graus de liberdade