Questões de Concurso sobre Regressão Linear Múltipla


Disciplina
Assunto 1
Banca
Instituição
Cargo
Ano
Carreira
Área de formação
Escolaridade
Dificuldade
 
Comentários:
Professores
Alunos
Meus Comentários
Vídeo
 
Minhas questões:
Resolvidas
Não resolvidas
Certas
Erradas
 
Tipo de questão:
Certo e errado
Múltipla escolha
Incluir questões:
Anuladas
Desatualizadas
 
Questões:
Todas as questões
 
Filtro simplificado
 
Questões
Todas as questões
 
146 questões encontradas
Questões por página
20
Mais recentes
 

Considerando-se que, em uma regressão múltipla de dados estatísticos, a soma dos quadrados da regressão seja igual a 60.000 e a soma dos quadrados dos erros seja igual a 15.000, é correto afirmar que o coeficiente de determinação — R2 — é igual a


A

0,75.


B

0,25.


C

0,50.


D

0,20.


E

0,80.

Um economista tem a sua disposição o seguinte conjunto de informações para estimação de uma função demanda dada por Q1i = β1P1i + β2P2i + εi:


(X' X)-1 =  Imagem associada para resolução da questão ∑Q1iP1i = 552 ∑Q1iP2i = 696 ∑Q21i= 1976


Número de observações: 6


Considere que Q1i é a quantidade de demanda do bem P1i e P2i são os preços do bem 1 e do bem 2, respectivamente, e que o modelo respeita todos os pressupostos associados ao modelo clássico de regressão linear múltiplo.


Qual será a estimativa dos parâmetros β1 e β2, respectivamente, e a estatística F desse modelo?



A

-4,6 e F = 492


B

-6,4 e F = 634


C

-8,12 e F = 544


D

-2,3 e F = 236

Um economista tentando estimar os preços dos apartamentos disponíveis para venda definiu o seguinte modelo: lnyi=β0+β1 lnxi+β2 Di+ui , em que Yi representa o preço dos apartamentos em reais, xi é o tamanho do imóvel, medido em m2 , Di é uma variável dummy indicando se existe um parque ou praça pública, no raio de 200 metros de distância do imóvel, e ui é o termo de erro aleatório. O modelo foi estimado pelo método dos mínimos quadrados ordinários, com uma amostra de tamanho n = 732 e o resultado da estimação está descrito, a seguir.


Parâmetro

Coeficiente

Erro-padrão

p-valor

β0

10,66

0,085

0,000

β1

0,30

0,019

0,000

β2

0,12

0,06

0,067

R 2 = 0,95 R 2 ajust. = 0,94


De acordo com os resultados estimados, a existência de um parque próximo ao imóvel, aumenta o seu valor, ceteris paribus, em


A

R$ 0,12.


B

R$ 12,00.


C

0,12%.


D

12%.

Sabe-se que além de estimar os parâmetros dos modelos, uma parte importante da econometria está relacionada aos testes de hipóteses que são feitos com as estimações. Nesse contexto, o intervalo de confiança torna-se uma ferramenta importante para realizar testes de hipóteses e sair da estimativa “pontual” e entrar na estimativa de “intervalo”.


Considerando os estimadores de Mínimos Quadrados Ordinários, assumindo que todas as hipóteses do Modelo Clássico de Regressão Linear são satisfeitas, para um modelo de regressão simples amostral do tipo = + + considere as proposições sobre o intervalo de confiança para o parâmetro .


I. Mantendo os demais fatores constantes, quanto maior a variabilidade nos valores da variável X, maior tende a ser a amplitude do intervalo de confiança.

II. Mantendo os demais fatores constantes, quanto maior o nível de significância escolhido, maior tende a ser a amplitude do intervalo de confiança.

III. Mantendo os demais fatores constantes, quanto maior o número de observações da amostra, menor tende a ser a amplitude do intervalo de confiança.


Assinale a alternativa correta.


A

( ) Somente a afirmativa III é verdadeira.


B

( ) Somente a afirmativa I é verdadeira.


C

( ) Somente a afirmativa II é verdadeira.


D

( ) Somente as afirmativas I e II são verdadeiras.


E

( ) Somente as afirmativas II e III são verdadeiras.

Para um modelo de regressão linear múltiplo, o teste de White permite detectar a heteroscedasticidade a partir da regressão de cada erro estimado da regressão original com as variáveis explicativas e seus inversos.

C
Certo

E
Errado

No caso da seleção de Modelos de Regressão Múltipla por meio do grau de aderência e do nível de captura das variações da variável explicada, alguns cuidados devem ser tomados.

Dentre esses, cabe destacar que:


A
a introdução de uma variável explicativa pode reduzir o grau de aderência medido pelo coeficiente de determinação;

B
a relação de causa e efeito entre as variáveis do modelo pode ser assegurada por estatísticas R2 e F-Snedecor elevadas;

C
ao contrário do coeficiente R2 clássico, o R2 ajustado tem um padrão monótono à variação do número de regressores;

D
em regressões que não apresentem intercepto, a relevância do R2 para a avaliação do modelo fica amplificada;

E
o R2 ajustado penaliza a introdução de novos regressores, mas ainda assim pode sinalizar uma melhoria do modelo.

Imagem associada para resolução da questão

Assim sendo, é correto afirmar que:


A
o R2 do modelo estimado é igual a 40%;

B
a estatística F-Snedecor observada é igual a 6;

C
a variância estimada dos resíduos é igual a 40;

D
ao nível de significância de 98%, o modelo é rejeitado;

E
o valor do R2 ajustado é igual a 0,55.

A multicolinearidade é uma das dificuldades que pode ocorrer no processo de estimação de Modelos de Regressão Múltipla. Em casos mais severos, a multicolinearidade chega a impossibilitar a obtenção de estimativa, mas mesmo quando tal não se dá, outros problemas podem advir.

Como exemplo, seria possível dizer que:


A
os estimadores de mínimos quadrados dos parâmetros tornam-se menos eficientes, por aumento das variâncias;

B
algumas das variáveis perdem por completo a sua capacidade de explicar o comportamento da variável dependente;

C
o resultado da inferência estatística sobre o modelo torna-se menos confiável, por viés da estatística F-Snedecor;

D
é necessário usar a estatística t-Student para testar as variáveis e retirar do modelo aquelas menos significativas;

E
os resultados da inferência do modelo como um todo e sobre os parâmetros, individualmente, podem ser inconsistentes.

Considere o modelo de regressão linear múltipla com intercepto, da variável dependente Y sobre as p variáveis independentes (X1, X2, ..., Xp), na forma matricial:

E(Y) = X.

Utilizando uma amostra de tamanho n, obtemos o estimador dos mínimos quadrados ordinários =(XTX)-1XTY. Os valores estimados de Y, =X, podem ser expressos por meio de = X.(XTX)-1XTY.

Fazendo H = X.(XTX)-1XT, tem-se =H.Y, sendo a matriz n x n, H, denominada matriz de projeção, isto é, a matriz que projeta o vetor das observações amostrais, Y, no espaço dos valores estimados .

Diante das considerações feitas acima, observe as afirmações a seguir.:

I - H é uma matriz idempotente.

II - = rank(X) = p, onde hii é o iº elemento da diagonal da matriz H.

III - H.(I – H) = O, onde I é a matriz identidade e O, a matriz nula.

IV - e = (I – H).Y, onde e é o vetor dos resíduos amostrais.

Está correto o que se afirma em:


A

I, II e III, apenas


B

I, II e IV, apenas


C

I, III e IV, apenas


D

II, III e IV, apenas


E

I, II, III e IV

Dado o valor crítico da estatística t de Student para 8 graus de liberdade a 5% de significância, t8;5% = 2,3, rejeita-se a hipótese de que cada um dos coeficientes da regressão seja nulo.

C
Certo

E
Errado

Um modelo de Regressão Múltipla tem a sua equação estimada como Imagem associada para resolução da questão, sendo E(ui/x2i,x3i)=0. Sobre este modelo pode-se afirmar que:
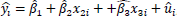

A

No teste de significância global de regressão da amostra deve ser analisada separadamente a possibilidade de βi (i = 2 e 3) ser diferente de zero, e desta forma H0:β2 =0 e H0:β3=0.


B

No teste de significância global de regressão da amostra deve ser utilizada a estatística t de student para a verificação se o valor calculado da estatística t supera, ou não, seu valor crítico de significância determinado para o teste.


C

O teste, por meio da técnica da Análise de Variância (ANOVA) tem grau de liberdade igual a 3 para a fonte de variação proveniente da Regressão.


D

O teste, por meio da técnica da Análise de Variância (ANOVA) tem grau de liberdade igual a (n-3) para a fonte de variação proveniente dos Resíduos.


E

A estimativa do Intervalo de Confiança para cada um dos coeficientes é determinado com o valor estimado de cada coeficiente somado/subtraído da sua margem de erro, esta formada pelo valor da estatística normal padronizada (estatística z), multiplicada pelo erro padrão de cada um dos seus coeficientes.

Um pesquisador estimou um modelo linear de regressão relacionando a escolaridade da pessoa com as escolaridades do pai, da mãe e o sexo da pessoa. Como de praxe, o modelo inclui também uma constante entre as variáveis independentes. A respeito dessa regressão, afirma-se o seguinte.


I) Os coeficientes obtidos terão os mesmos valores se o modelo for estimado com as variáveis forem medidas como desvios em relação a sua média.

II) Uma transformação logarítmica dos dados pode ser adequada, se os resíduos apresentarem heterocedasticidade.

III) Pode-se representar o sexo do filho por uma variável binária para cada sexo: masculino e feminino.

IV) Se o coeficiente de determinação da regressão for baixo, isso significa que os coeficientes não são estatisticamente significativos e as variáveis dependentes não são adequadas.


Podemos afirmar que:


A

a afirmação IV é correta.


B

a afirmação I é correta.


C

apenas a afirmação III é incorreta.


D

as afirmações III e IV são incorretas.


E

apenas a afirmação II é incorreta.

Considere-se uma amostra aleatória bivariada (U1,V1), ... , (U100,V100) e um modelo de regressão linear na forma , em que é um erro aleatório com média 0 e variância igual a 1. Com base nessas informações, o desvio padrão da soma V1 + ... + V100 será igual a


A

0,01.


B

0,1.


C

1.


D

10.


E

100.

Um modelo de regressão linear múltiplo será adotado para realizar imputações, em razão de algumas lacunas de dados em um levantamento de campo. As variáveis consideradas são o consumo de feijão (anual), o número de adultos equivalente e a renda (mensal do domicílio). O modelo formulado foi:

Para i = 1, 2, 3 , .... 28 (domicílios)

Os resultados da estimação estão na tabela abaixo:
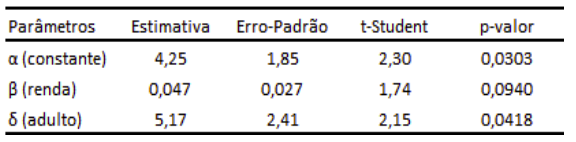
Imagem associada para resolução da questão

A partir dos números acima, é correto concluir que:



A

se a renda de um domicílio for acrescida de 100 unidades monetárias, o consumo de feijão deverá sofrer um acréscimo médio de 4,7 Kg do produto;


B

ao nível de significância de 10% a renda é não significativa para explicar o consumo de feijão;


C

para cada 1% de variação no número de adultos equivalentes no domicílio, o consumo de feijão será acrescido de 5,17%;


D

se uma família com quatro adultos equivalentes ganha 1.000 unidades monetárias, o consumo médio imputado seria de 71,83 quilos de feijão;


E

o consumo médio de feijão de uma pessoa desempregada (sem renda) é de 4,25 quilos de feijão anuais.

Em modelos de regressão múltipla, alguns pressupostos complementares são formulados para que os parâmetros possam ser estimados de forma satisfatória. Um deles trata da micronumerosidade e outro do tamanho da amostra.

Sobre essas duas adições, é correto afirmar que:


A
quanto mais intensa for a micronumerosidade, mais precisos serão os estimadores de MQO;

B
o número de parâmetros de um modelo deve ser sempre superior ao tamanho da amostra disponível para a estimação;

C
quanto maior o número de parâmetros em uma regressão, menor será a variância estimada dos erros;

D
se duas variáveis estão provocando a micronumerosidade, ambas devem ser excluídas da equação de regressão;

E
a micronumerosidade pode não ser um problema sério caso a regressão seja usada para projeções e não para estimações.

Imagem associada para resolução da questão


A

o parâmetro β 2 obteve a estimação mais precisa pois seu erro padrão foi menor.


B

os coeficientes estimados são significativos a nível de significância 5%.


C

não se rejeita a hipótese β 0=0 a nível de significância 1%.


D

se rejeita a hipótese β 1=0 a nível de significância 5%.

O modelo clássico de regressão linear é um instrumento fundamental para a maior parte da teoria econométrica.Assinale a alternativa que contém uma hipótese válida para este modelo de regressão linear simples dado por Yi = β1 + β2Xi + µi .


A

as perturbações são autocorrelacionadas.


B

existe forte covariância entre Xi e µi.


C

a variância de µi é a mesma para todas as observações.


D

o valor esperado do termo de perturbação aleatória é igual a unidade.


E

é um modelo exponencial em seus parâmetros.

   
Gerar simulado