







Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
O setor B apresentou redução contínua no número de processos concluídos entre janeiro e março.
Certo
Errado
Para testar H0: µ ≥ 40 versus H1: ɥ < 40, em que µ é a média de uma variável populacional, uma amostra aleatória simples de tamanho n = 625 foi obtida e apresentou os seguintes dados:
xˉi=1∑625(xi−xˉ)2=38,8=9.984
Nesse caso, o critério de decisão mais indicado rejeitará H0, ao nível de significância de 5%,se
𝑥̅< 39,738, de modo que Ho deve ser rejeitada.
𝑥̅> 39,813, de modo que Ho não deve ser rejeitada.
𝑥̅< 38,016, de modo que Ho não deve ser rejeitada.
𝑥̅> 40,187, de modo que Ho não deve ser rejeitada.
𝑥̅< 39,813, de modo que Ho deve ser rejeitada.
A respeito do ciclo iterativo da metodologia de Box e Jenkins, avalie as afirmativas a seguir.
I. Na etapa de Identificação busca-se determinar qual versão dos modelos de Box-Jenkins, sazonais ou não, melhor descreve o comportamento da série. A identificação do modelo a ser estimado ocorre pelo comportamento das funções de autocorrelações (ACF) e das funções de autocorrelações parciais (PACF).
II. A etapa de Estimação consiste em estimar os parâmetros do componente autorregressivo, os parâmetros do componente de médias móveis e a variância de εt.
III. A etapa de Verificação é dedicada a avaliar se o modelo estimado é adequado para descrever o comportamento dos dados.
Está correto o que se afirma em
I, apenas.
I e II, apenas.
I e III, apenas.
II e III, apenas.
I, II e III.
Com relação às propriedades e relações entre distribuições de probabilidade, assinale a alternativa correta.
O quadrado de uma variável aleatória com distribuição exponencial é uma variável aleatória com distribuição qui-quadrado com 2 graus de liberdade.
A soma de variáveis aleatórias independentes com distribuição normal padrão é uma variável aleatória com distribuição qui-quadrado.
O produto de variáveis com distribuição Poisson com parâmetro λ é um caso particular de uma distribuição exponencial com parâmetro λ.
O quadrado de uma variável aleatória com distribuição normal padrão é uma variável aleatória com distribuição qui-quadrado com 1 grau de liberdade.
O produto de variáveis com distribuição exponencial com parâmetro λ é um caso particular de uma distribuição gama (1, λ).
Sejam X1 , X2 , ..., Xn uma amostra aleatória de uma população com distribuição Normal N(µ, σ2 ), com σ2 = 20. Considere o teste de hipóteses H0 : µ = 50 contra H1 : µ > 50, com base na média amostral X, com tamanho amostral n = 20 e nível de significância α = 0,05. Suponha que a regra de decisão seja rejeitar H0 sempre que X > 51,645. Seja Z ~ N(0, 1) a variável aleatória com distribuição normal padrão.
Portanto, a probabilidade de erro tipo II do teste, quando µ = 52, é dada por
P(Z ≤ –0,355).
P(Z ≤ 0,355).
P(Z ≤ 1,645).
P(Z ≤ –1,645).
0,05.
Um indicador de eficiência institucional monitorou o número de reclamações diárias recebidas por uma ouvidoria durante sete dias corridos, gerando o seguinte rol de dados ordenados: 3, 4, 6, X, 9, 11, 12. Sabendo que a média aritmética simples desse período foi rigorosamente igual a 8 reclamações por dia, o gestor público precisa decodificar o valor omitido da variável X para concluir a análise estatística dos atendimentos daquela semana. Considerando isso, assinale a alternativa com a resposta CORRETA.
6.
11.
8.
9.
Considere um modelo de regressão linear simples ajustado para analisar a relação entre uma variável explicativa X e uma variável resposta Y. A tabela da ANOVA para o modelo estimado é apresentada seguir:

Com base nos dados apresentados, o valor do coeficiente de determinação ajustado (R2ajustado) do modelo é
0,66.
0,64.
0,60.
0,70.
0,55.
A amplitude do intervalo de confiança aumentaria caso o tamanho da amostra (número de dias de medição) fosse aumentado para 28, mantendo-se constantes as demais quantidades (nível de confiança e desvio-padrão).
Certo
Errado
Durante uma auditoria fiscal baseada em análise de dados, foram examinadas 20 observações das variáveis X e Y, nas quais X representa uma variável econômica declarada pelo contribuinte e Y, um indicador fiscal associado. A partir da base de dados, obtiveram-se as seguintes somatórias: ΣX = 4, ΣY = 9, ΣX2 = 42, ΣY2 = 80 e ΣXY = -20. Com base nessas informações, na análise de correlação e regressão linear simples de Y em função de X, conclui-se que
o coeficiente de correlação linear é negativo e inferior a 0,50, indicando fraca associação linear.
a covariância entre X e Y é positiva, o que implica coeficiente de correlação positivo e reta de regressão crescente.
o coeficiente de correlação linear é positivo e elevado, indicando forte associação linear entre as variáveis, o que invalida o uso do modelo de regressão para fins fiscais.
o coeficiente de correlação linear é aproximadamente nulo, indicando ausência de relação estatística entre as variáveis, e o coeficiente angular da regressão é exatamente zero.
a estimativa do intervalo de confiança do parâmetro de regressão contém o zero, apesar do coeficiente de correlação linear ser negativo, em razão da influência do termo constante.
A e B são dois eventos tais que P[A] = 0,7 e P[B] = 0,2.
Os valores mínimo e máximo de P[A◡ B] são, respectivamente,
0,2 e 0,7.
0,7 e 0,9.
0,5 e 0,9.
0,2 e 0,9.
0,5 e 0,7.
Considere que o número de ocorrências registradas nos últimos 10 dias do mês na Polícia Civil foi: 5, 10, 7, 9, 2, 4, 4, 6, 11, 1. O valor mediano do número de ocorrências por dia é de:
4.
4,5.
5.
5,5.
6.
Sobre a curva ROC (Receiver Operator Characteristic), assinale a alternativa INCORRETA.
É uma técnica gráfica que pode ser utilizada para quantificar a acurácia global de um teste diagnóstico.
Mostra o contrabalanço entre a sensibilidade e a especificidade de um teste e pode ser utilizada para auxiliar na decisão do melhor ponto de corte.
Mostra as taxas de verdadeiros positivos no eixo X e as taxas correspondentes de falsos positivos no eixo Y, apresentando área com valor máximo de 0,5.
Quanto maior a área sob a curva ROC, melhor ou mais adequado será o teste para a tomada de decisão.
As curvas ROC são especialmente valiosas para comparar testes alternativos para um mesmo diagnóstico.
Em situações que a variável resposta 𝒚𝒊 é dicotômica, tem-se que 𝒚𝒊 segue uma distribuição de Bernouli com parâmetro p, ou seja, 𝒚𝒊~𝑩𝒆𝒓(𝝅𝒊), para 𝒊 = 𝟏, … , 𝒏. Suponha que uma covariável 𝒙𝒊 está associada para cada observação i. Usando a função de ligação logito, temos que 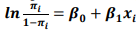 . Com base no exposto, é correto afirmar que o modelo logístico é dado por
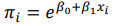
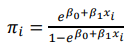
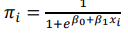
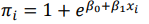
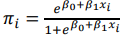
A máquina de vetores de suporte (SVM - Support Vector Machine) se popularizou, por exemplo, devido ao sucesso em aplicações envolvendo reconhecimento de padrões. Escolha a alternativa abaixo que representa uma limitação da SVM.
Interpretabilidade.
Classificação binária.
Relações não lineares.
Modelagem de dados contínuos.
Como ܻ segue distribuição normal, a estatística do teste dada pela expressão 3040y segue uma distribuição normal padrão.
Certo
Errado
Considerando dois eventos independentes X e Y, tais que 𝑃(𝑋 ∪ 𝑌) = 0,8 e 𝑃(𝑋) = 0,5, assinale a opção que apresenta o valor da probabilidade 𝑃(𝑌).
0,6
0,5
0,4
0,3
0,0
A probabilidade de seleção de cada obra na amostra é igual entre as categorias, uma vez que foram selecionadas 100 obras de cada uma delas.
Certo
Errado
Martinha, uma analista da ALEGO, desenvolveu o programa Python (versão 3) que utiliza as bibliotecas numpy (2.0.2) e scikitlearn (versão 1.6.1) para realizar análise discriminante linear. Analise o programa a seguir.
import numpy as np
from sklearn.discriminant_analysis import
LinearDiscriminantAnalysis
X = np.array([[-1, -1], [-2, -1], [-3, -2],
[1, 1], [2, 1], [3, 2], [1, 2]])
y = np.array([1, 1, 1, 2, 2, 2, 2])
clf = LinearDiscriminantAnalysis()
clf.fit(X, y)
print(clf.predict([[-0.8, -2]]))
O resultado impresso é igual a
[0].
[1].
[2].
[3]
[-1].
Em um modelo de regressão múltipla estimado por mínimos quadrados ordinários, observa-se que duas variáveis explicativas apresentam correlação muito alta entre si. Adicionalmente, um dos coeficientes estimados apresenta sinal contrário ao esperado pela teoria, e os erros-padrão dos coeficientes são substancialmente elevados.
A partir dessa situação hipotética, é correto concluir que o modelo em questão apresenta
endogeneidade, o que viola o pressuposto de exogeneidade das variáveis explicativas e gera estimativas inconsistentes que não convergem para os valores verdadeiros mesmo com amostras grandes.
autocorrelação dos resíduos, o que provoca perda da propriedade de eficiência dos estimadores e invalida completamente a capacidade preditiva do modelo ajustado.
erro de especificação por omissão de variável relevante, sendo necessário identificar e incluir a variável faltante para corrigir os sinais inesperados dos coeficientes.
multicolinearidade, o que resulta em estimativas com variância inflada e interpretações individuais dos coeficientes pouco confiáveis.
heterocedasticidade, o que implica estimativas viesadas dos coeficientes e torna os testes de hipótese não confiáveis para inferências sobre os parâmetros populacionais.
Para otimizar a precisão de um levantamento sobre indicadores sociais, o estatístico decide subdividir a população em subconjuntos mutuamente exclusivos que apresentam características internas semelhantes, realizando o sorteio de forma independente em cada um deles. Com base nessas informações, assinale a alternativa que apresenta essa técnica de amostragem.
Sistemática.
Por conglomerados.
Por bola de neve.
Estratificada.
Censitária parcial.



