Seu próximo nível começa aqui
Com a Assinatura Ilimitada, você tem tudo que precisa para sua aprovação.
Com a Assinatura Ilimitada, você combina prática, teoria e método em uma única assinatura com tudo que você precisa para sua aprovação.
Sejam X1,...,Xn uma amostra aleatória de uma população com distribuição Weibull de parâmetros α e β. A função densidade de probabilidade de Xi é dada por f(xi|α, β) = {βaxia−1e−βxia,para x>0;0 ,caso contraˊrio; para α, β > 0 e i = 1, ..., n. Para α = 1, o estimador de máxima verossimilhança para β é:
β^ =Xˉ
β^ =X1
β^ =Xˉ2
β^ =X21
β^ =(∑i=1nxi)−1
Seja X uma variável aleatória com distribuição uniforme
(0,θ), em que θ > 0. Para estimar o parâmetro θ por máxima
verossimilhança (MV) ou pelo método dos momentos (MM),
seleciona-se uma amostra de tamanho n. Se
MV e
MM são
os estimadores de máxima verossimilhança e método dos
momentos, respectivamente, e EQM(
) o erro quadrático
médio do estimador, é correto afirmar que
MV é não viciado e é consistente.
Var(
MM) = θ2/
MM não é consistente.
MM é não viciado.
EQM(
MM) < EQM(
MV).
Considere uma linha de produção em que a probabilidade de ocorrer um defeito é p. A distribuição de probabilidade da variável aleatória X que conta os itens até que ocorra o primeiro defeito é a distribuição geométrica, dada por: f(x,p)=(1-p)x-1p, para x=1,2,... e 0<p<1.
Suponha que uma amostra aleatória de X tenha sido selecionada e que se deseja obter uma estimativa de máxima verossimilhança de p, utilizando o método iterativo de Newton Raphson. Nesse caso, a equação de iteração do método é
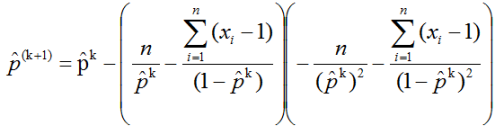
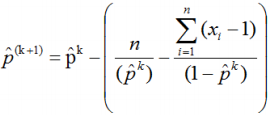
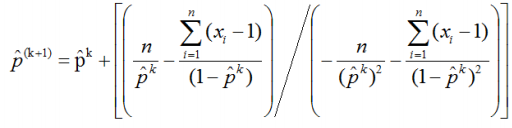
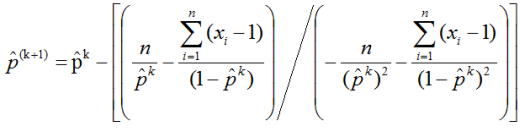
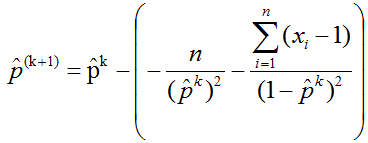

Durante um período de 10 anos (de 2008 a 2017), foi registrado, em cada ano, o faturamento anual (F) de uma empresa, em milhões de reais, e o respectivo gasto anual com propaganda (G), em milhões de reais. Um modelo de regressão linear simples Ft = α + βGt + εt , t = 1, 2, ... foi elaborado para se prever F em função de G, considerando as informações registradas, em que F1 e G1 são o faturamento e o gasto com propaganda em 2008, F2 e G2 são o faturamento e o gasto com propaganda em 2009, e assim por diante. Os parâmetros α e β são desconhecidos e εt é o erro aleatório com as respectivas hipóteses do modelo de regressão linear simples. As estimativas de α e β foram obtidas pelo método dos mínimos quadrados, sabendo-se que o valor da soma dos faturamentos e dos gastos com propaganda de 2008 a 2017 foram, em milhões de reais, iguais a 120 e 15, respectivamente. Se a estimativa do coeficiente angular da reta obtida por meio do método dos mínimos quadrados foi de 1,8, então a previsão do faturamento em um determinado ano, uma vez que a empresa gastou com propaganda neste ano 2 milhões de reais, é
15,4 milhões de reais.
16,0 milhões de reais.
14,4 milhões de reais.
12,9 milhões de reais.
13,6 milhões de reais.
Sendo (X1, X2,...,Xn) uma amostra de uma variável aleatória com distribuição de probabilidade Gama com parâmetros λ e r, é correto afirmar que a função de máxima verossimilhança com base nessa amostra é
f(x)=Γ(r)λr Xr−1 e −λx, X>0
1nL(x,λ,r)=nr1nλ−n1nΓ(r)+(r−1)n∑i=11nXi−λn∑i=1Xi
L (x,λ,r) (n∏i=1)r−1 exp⎩⎪⎨⎪⎧−λn∑i=1⎭⎪⎬⎪⎫
L (x,μ)= σn(2π)n1 exp⎩⎪⎨⎪⎧−2σ²1n∑i=1(Xi−µ)²⎭⎪⎬⎪⎫
L (x,λ)=λn exp⎩⎪⎨⎪⎧−λn∑i=1Xi⎭⎪⎬⎪⎫
Se X1, X2, ..., Xn é uma amostra aleatória simples de uma distribuição Bernoulli (p), então o estimador de máxima verossimilhança da variância populacional é
X.
∑i=1n(X1−X)2 /n.
∑i=1n=(Xi −X)2/ (n−1).
∑i=1n= (Xi −X)2/2n.
∑i=1n= Xi /2n.
Suponha que o tempo de vida de uma bactéria segue uma distribuição Gama com média 0,0002 e desvio padrão igual a 0,0001. Considerando que foi observado o tempo de sobrevivência (em horas) destas bactérias no organismo e que são n = 5 bactérias. A alternativa que indica corretamente a função de máxima verossimilhança é dada por:
p(x,θ)=
∏i=15[Γ(0,0001)(20000)0,0001]*
∏i=15[xi0,0001−1]e−∑i=1520000xi
p(x,θ)=∏i=15[Γ(2000)(4)2000] *∏i=15[xi3] e−∑i=152000xi
p(x,θ)=
∏i=15[Γ(0,0001)(0,0002)0,0001]*
∏i=15[xi0,0001−1]e−∑i=150,0002xi
p(x,θ)=
∏i=15[Γ(0,0002)(0,0001)0,0002] * ∏i=15[xi3]e−∑i=150,0002xi
p(x,θ)=
∏i=15[Γ(4)(20000)4] * ∏i=15[xi3]e−∑i=1520000xi
Seja X uma variável aleatória com função de probabilidade dada por P(X=x)=p.(1−p)x-1 para x = 1, 2, 3,..., onde p é um parâmetro desconhecido. Dispondo de uma amostra de tamanho n, x1, x2, x3, ... . . , xn, o estimador de Máxima Verossimilhança de p é:
p^=∑xi ;
p^=∑xi1 ;
p^=n∑xi ;
p^=∑xin ;
p^=n∑xi .
Segundo o livro de Bussab e Morettin: “O princípio da verossimilhança (L(θ∣X)) afirma que se deve escolher aquele valor do parâmetro desconhecido que maximiza a probabilidade de obter a amostra particular observada, ou seja, o valor que torna aquela amostra a “mais provável”. O uso desse princípio conduz a um método de estimação pelo qual se obtêm os chamados estimadores de máxima verossimilhança que, em geral, têm propriedades muito boas. Esse princípio foi enunciado por Fisher pela primeira vez em 1912 e, em 1922, deu-lhe forma mais completa, introduzindo a expressão “likelihood” (verossimilhança).”
Sendo assim, considere um vetor de variáveis aleatórias X=(X1,X2,...,X10) Independentes e identicamente distribuídas com distribuição Binomial dada por Xi~Binominal(n=10,p=0,0938) . Assinale a alternativa que expressa a função de log verossimilhança (l(θ∣x)) para esse conjunto de variáveis aleatórias.
l(p;x)=∑i=110[log(xi10)+xilog(0,0938)+(10−xi)log(0,9062)]
l(p;x)=∑i=110[log(xi10)+xilog(0,0938)+(10−xi)log(0,0962)]
l(p;x)=∑i=110[log(n10)+xilog(0,0938)+(10−xi)log(0,9062)]
l(p;x)=∑i=110[log(xi100)+xilog(0,0938)+(10−xi)log(0,9062)]
l(p;x)=∑i=1100[log(xi10)+xilog(0,0938)+(10−xi)log(0,0962)]
Suponha-se que 𝑌 seja uma variável aleatória discreta, tal que 𝑃(𝑌 = −1) = 𝜃 e 𝑃(𝑌 = 1) = 1 − 𝜃, em que 0 < 𝜃 < 1. Se 𝑌1 , … , 𝑌𝑛 representar uma amostra aleatória simples retirada da distribuição 𝑌, então o estimador de máxima verossimilhança de 𝜃 será igual a
ө^ = nY1+...+Yn .
ө^ = nY12+...+Yn2 .
ө^ = n(Y1+...+Yn)2 .
ө^ = ∣∣∣nY1+...+Yn∣∣∣ .
ө^ = 21−nY1+...+Yn .

Considere uma aplicação do modelo linear tradicional de regressão. O gráfico dos valores dos resíduos em função das observações da variável resposta sugeriu fortemente que a dispersão nos resíduos era proporcional ao valor da respectiva observação da variável resposta. Dessa forma, podemos afirmar que há indícios de que:
a suposição de normalidade dos resíduos foi violada.
a suposição de homoscedasticidade dos resíduos foi violada.
há presença de heteroscedasticidade nos erros.
os erros não seguem uma distribuição normal.
Em um modelo de regressão linear simples, considerando válidas todas as suposições, com exceção da de normalidade, qual classe de estimadores possui a propriedade de gerar os melhores estimadores lineares não viesados?
Momentos.
Mínimos quadrados.
Máxima verossimilhança.
Bayes.

Sejam X1, X2, ..., Xn variáveis aleatórias independentes com distribuição dada por:
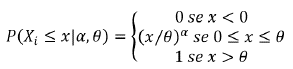
o estimador de máxima verossimilhança para o parâmetro θ é dado por ![]()
os estimadores de máxima verossimilhança para os parâmetros α, θ dado por
não podem ser obtidos numericamente.
não é possível encontrar estimadores de máxima verossimilhança para essa distribuição.
os estimadores de máxima verossimilhança para os parâmetros θ e α são dados respectivamente por ![]()
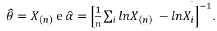
os estimadores de máxima verossimilhança de α, θ dados por
são estimadores não viciados e portanto consistentes.